Сбор данных из социальных сетей: задачи, подходы и критерии выбора инструментов
Социальные сети давно стали не только каналом общения, но и крупным источником прикладных данных. Публикации, комментарии, реакции, хэштеги, сведения о профилях и динамика вовлеченности помогают компаниям оценивать интерес аудитории, отслеживать изменения спроса, наблюдать за конкурентной средой и точнее выстраивать рабочие решения. Но получить такие данные в пригодном для анализа виде можно не вручную, а только через системный сбор и обработку.
Скрапинг социальных сетей — это извлечение общедоступной информации с платформ и сервисов. Речь идет не о хаотичном копировании отдельных страниц, а об организованном процессе, при котором данные собираются автоматически, структурируются и передаются в дальнейшую аналитику. Такой подход избавляет от ручной работы, снижает количество ошибок и позволяет работать с объемами, которые невозможно обработать вручную.
Какие данные обычно собирают
Набор доступных данных зависит от платформы и выбранного инструмента, но чаще всего компании работают с несколькими типами информации.
К первой группе относятся данные профилей: имена пользователей, отображаемые имена, описания, изображения, сведения о подписчиках и подписках, а иногда и географические признаки, если они доступны публично.
Вторая группа — публикации. Сюда входят тексты постов, подписи, изображения, видео, дата и время размещения, а также привязанные к публикации теги и ссылки.
Третья группа — метрики вовлеченности. Обычно это лайки, комментарии, просмотры, репосты, ретвиты, сохранения и другие показатели, по которым можно оценивать реакцию аудитории.
Отдельную ценность представляют комментарии: их содержание, временные метки, ответы, авторы и характер взаимодействия вокруг конкретной темы. Именно этот массив данных часто используется при анализе отношения аудитории к бренду, продукту или событию.
Дополнительно могут собираться данные по хэштегам, тематическим обсуждениям, страницам компаний, группам и в некоторых случаях — сведения о товарах, если социальная платформа включает элементы маркетплейса.
Резидентские и дата-центровые IP для автоматического сбора данных
Работайте с веб-краулерами и скрейперами через IP из разных регионов.
Для чего бизнесу нужен сбор данных из соцсетей
Практическая ценность такого сбора определяется не самим фактом получения информации, а тем, как она используется в работе.
Бизнес-аналитика
Социальные платформы позволяют видеть, как аудитория реагирует на контент, какие темы вызывают отклик, какие форматы работают лучше и какие приемы используют конкуренты. На основе этих данных компании корректируют контент-стратегию, меняют приоритеты в коммуникации и точнее оценивают собственную заметность в цифровой среде.
Анализ тональности
Комментарии, отзывы, обсуждения и упоминания помогают понять, как воспринимается бренд или конкретный продукт. Если доля негативных реакций растет, это может указывать на проблему, требующую немедленного внимания. Если наоборот усиливается положительный фон, это дает основание закреплять удачные решения и масштабировать их.
Поиск лидов и рабочих контактов
В ряде сценариев данные из социальных сетей используются для поиска потенциальных клиентов, партнеров, представителей целевой аудитории или специалистов из нужной отрасли. Особенно это важно там, где необходимо быстро формировать релевантные списки контактов или выявлять активных участников определенной ниши.
Анализ трендов
Социальные сети часто становятся первой средой, где появляются новые темы, форматы и потребительские сигналы. Системный сбор данных помогает заметить изменения раньше, чем они перейдут в зрелую рыночную фазу. Для бизнеса это означает возможность быстрее реагировать на запросы аудитории и своевременно адаптировать продукт, коммуникацию или рекламную стратегию.
Поддержка решений на основе фактов
Когда стратегия строится не на предположениях, а на реальных сигналах аудитории, у бизнеса появляется более надежная основа для действий. Сбор данных из социальных сетей помогает увидеть повторяющиеся претензии, частые запросы, сильные и слабые стороны коммуникации, а затем использовать эти выводы в маркетинге, продуктовой работе и обслуживании клиентов.
Какие подходы используют для сбора данных
Универсального метода нет. Выбор зависит от задач, технической подготовки команды, бюджета и масштаба проекта. На практике чаще всего используют три варианта: собственные скрипты, API и no-code инструменты.
Роль прокси при сборе данных из социальных сетей
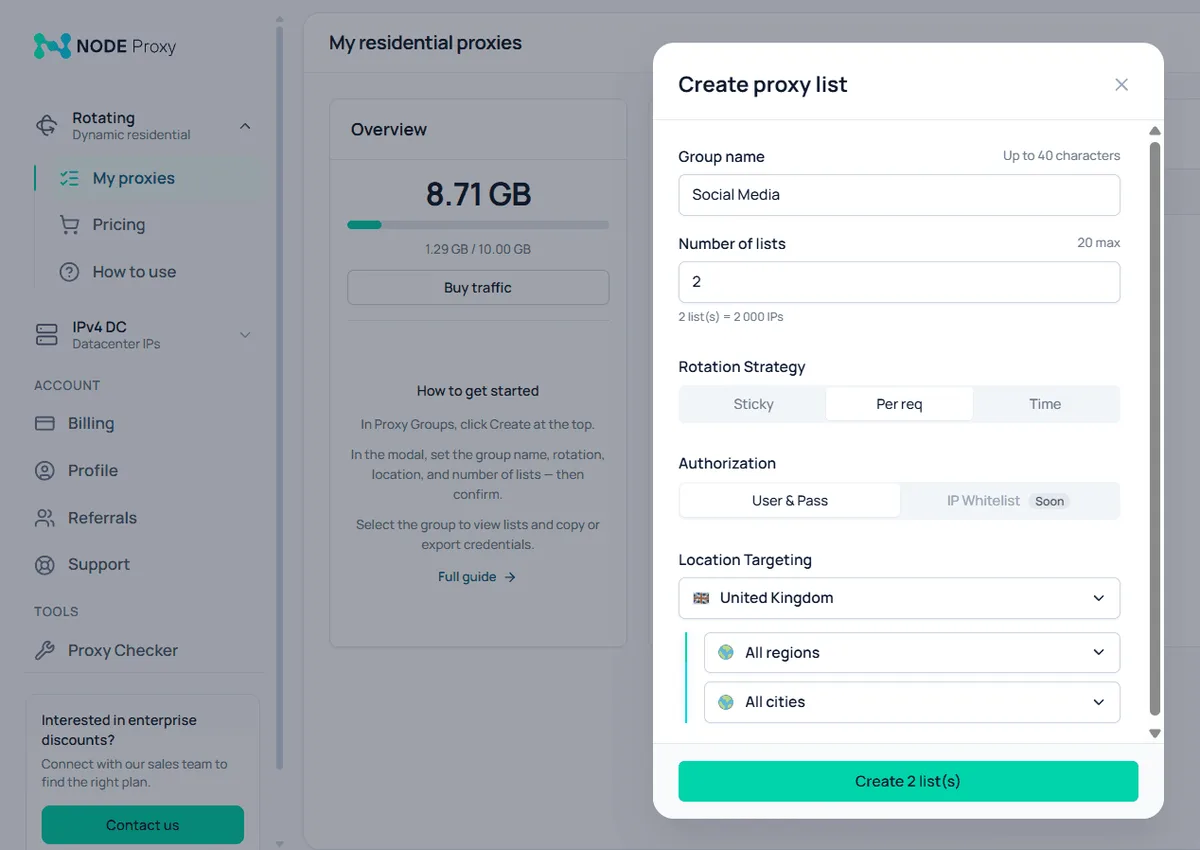
При сборе данных из социальных сетей важна не только логика извлечения, но и устойчивость самого процесса. Социальные платформы отслеживают нетипичную активность: большое количество однотипных запросов, повторяющиеся обращения с одного адреса, слишком высокую частоту действий и другие признаки автоматизации. Из-за этого даже корректно настроенный инструмент может работать нестабильно, если не учитывать сетевую часть процесса.
Прокси в такой схеме используются как технический инструмент, который помогает распределять запросы и снижать риск сбоев при массовом сборе данных. Они особенно важны в тех случаях, когда парсинг ведется регулярно, охватывает большие объемы страниц или выполняется сразу по нескольким источникам. В более сложных сценариях прокси также позволяют гибко управлять маршрутизацией запросов и поддерживать стабильность длительных задач.
Их значение зависит и от выбранного подхода к сбору. В собственных скриптах прокси обычно приходится подбирать, подключать и контролировать отдельно. В scraping API и no-code сервисах эта функция нередко уже встроена в инфраструктуру платформы, что упрощает запуск и снижает нагрузку на команду. Поэтому при выборе инструмента важно заранее понимать, как именно в нем организована работа с сетевыми запросами и входит ли такая возможность в базовую конфигурацию.
Прокси не заменяют качественную настройку самого сбора, но в практической работе остаются одним из ключевых элементов устойчивой инфраструктуры. Если инструмент рассчитан на регулярное извлечение данных из социальных платформ, вопрос поддержки прокси, как правило, нужно оценивать наравне с масштабируемостью, удобством настройки и качеством выгрузки данных.
Про то, какую роль играю прокси в рыночной аналитике, можно прочитать в этой статье.
Самостоятельно разработанные скрипты
Этот вариант выбирают в тех случаях, когда нужны гибкость, точная настройка и контроль над логикой сбора. Обычно такие решения пишут на Python или JavaScript, причем Python остается самым распространенным выбором благодаря понятному синтаксису, большому количеству библиотек и активному сообществу.
Собственный скрапер позволяет детально определить, какие именно данные собирать, как обходить страницы, как обрабатывать пагинацию, как хранить результаты и как встроить сбор в существующую инфраструктуру. Это полезно там, где шаблонные решения не закрывают задачу или где требуется нестандартная логика.
При этом такой подход требует серьезной технической подготовки. Недостаточно просто написать код, который извлекает данные со страницы. Нужно учитывать устойчивость к изменениям интерфейса, корректно обрабатывать динамический контент, поддерживать сценарии авторизации там, где это допустимо, и постоянно следить за стабильностью работы. По этой причине собственные скрипты оправданы в командах, где есть разработчики, готовые не только создать инструмент, но и сопровождать его дальше.
Преимущество этого пути — высокая настраиваемость и возможность собирать данные именно в том виде, который нужен бизнесу. Недостаток — высокая стоимость разработки и поддержки, а также зависимость от внутренних технических ресурсов.
API
Официальные API социальных платформ — самый структурированный и предсказуемый способ получать данные там, где такой доступ предоставляется. Обычно информация возвращается в формате JSON или XML, что упрощает интеграцию с аналитическими системами и внутренними сервисами.
Плюс API в том, что они рассчитаны на машинное взаимодействие и дают более стабильный канал доступа к данным. Кроме того, официальный доступ обычно лучше вписывается в установленные правила платформы. Это снижает операционные риски и делает работу более устойчивой в долгосрочной перспективе.
Однако у API есть ограничения. Они нередко вводят лимиты на число запросов, ограничивают набор доступных полей и не всегда позволяют получить ту глубину данных, которая нужна для сложной аналитики. В результате API хорошо подходят для задач, где важны надежность, предсказуемость и структурированность, но хуже работают там, где требуется максимальная полнота информации или нестандартные сценарии сбора.
Существуют и неофициальные scraping API. Они позволяют обращаться к данным через готовую инфраструктуру сервиса, который берет на себя технические детали. Это может быть удобным компромиссом между собственным кодом и no-code инструментом, но такой вариант все равно требует технического понимания и оценки качества поставщика.
No-code инструменты
No-code решения ориентированы на пользователей без навыков программирования. Обычно это сервисы с визуальным интерфейсом, готовыми шаблонами и простыми сценариями настройки. Они позволяют запустить сбор данных значительно быстрее, чем при самостоятельной разработке.
Преимущество такого подхода в доступности. Пользователь задает источник, выбирает нужные поля, настраивает периодичность и получает готовый результат в таблице, файле или через интеграцию с внешними системами. Многие сервисы дополнительно поддерживают экспорт в CSV, JSON, Excel, базы данных, Google Sheets и другие среды.
Еще одно важное достоинство — встроенные технические функции. У многих платформ уже предусмотрены средства управления сессиями, обработки динамических страниц, маршрутизации запросов и интеграции с автоматизированными рабочими процессами. Это сокращает объем ручной настройки.
Но no-code инструменты сильно зависят от конкретного поставщика. Разные сервисы отличаются по стабильности, стоимости, объему поддерживаемых платформ и глубине настройки. Для небольших и средних задач это часто удобное решение, но при масштабных нагрузках расходы могут быстро вырасти, а ограничения по гибкости — стать заметными.
На что смотреть при выборе инструмента
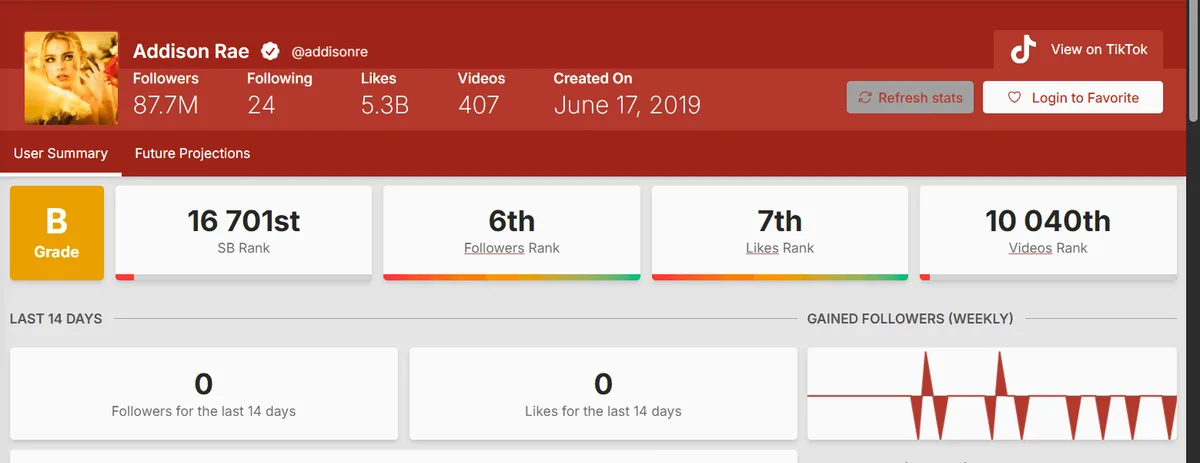
Выбор инструмента не стоит сводить только к цене или известности сервиса. Намного важнее понять, насколько решение подходит под конкретный рабочий сценарий.
Настраиваемость
Хороший инструмент должен позволять точно задавать, какие данные собираются, с каких страниц, по каким условиям и с какой периодичностью. Важно, чтобы можно было отдельно выбирать нужные поля и не перегружать выгрузку лишней информацией.
Масштабируемость
Если сегодня нужно собрать данные по одной теме, а завтра — по десяткам страниц и нескольким платформам, инструмент должен выдерживать рост нагрузки. Важно заранее оценить, способен ли он обрабатывать большие массивы данных и параллельно работать с несколькими источниками.
Простота использования
Даже функциональный сервис теряет ценность, если работа с ним требует лишних действий и постоянного вмешательства специалиста. Удобный интерфейс, понятная логика настройки и прозрачная документация напрямую влияют на скорость запуска и ежедневную эксплуатацию.
Формат и качество данных
Результат должен быть пригоден для анализа без дополнительной долгой очистки. Чем лучше инструмент структурирует данные на выходе, тем легче встроить их в отчеты, BI-системы, CRM или исследовательские процессы.
Интеграции
Если данные дальше используются в таблицах, аналитических панелях, автоматизированных сценариях или внутренних сервисах, важно проверить, насколько легко инструмент передает результаты в существующую инфраструктуру.
Законность и этика
Ключевой вопрос здесь не только в технической возможности получить данные, но и в характере информации, а также в целях ее использования. Когда речь идет об общедоступных данных и их применении для аналитики, маркетинговых исследований, оценки спроса или разработки стратегии, такой сбор обычно рассматривается в рамках допустимой деловой практики.
Но любые действия, связанные с получением закрытых пользовательских данных, учетных сведений, платежной информации или иной чувствительной информации, выходят за эти рамки. То же касается случаев, когда данные применяются не для анализа, а для недобросовестных действий.
Поэтому при работе с данными из социальных сетей важно соблюдать сразу несколько принципов: собирать только публично доступную информацию, четко ограничивать цели использования, не выходить за рамки правил платформы и не подменять исследовательскую задачу действиями, затрагивающими частную информацию пользователей.
Итог
Сбор данных из социальных сетей — это не отдельная техническая операция, а часть аналитической системы, которая помогает компаниям видеть реакцию аудитории, отслеживать тренды, оценивать эффективность контента и принимать решения на основе реальных сигналов, а не предположений.
Для одних задач достаточно no-code инструмента с готовыми шаблонами. Для других требуется API с предсказуемым доступом к данным. В более сложных случаях оправдана собственная разработка. Главный критерий выбора здесь не универсальность инструмента, а соответствие конкретной задаче: какие данные нужны, в каком объеме, с какой регулярностью и как они будут использоваться дальше.
Если это сделать правильно, данные из социальных сетей превращаются из разрозненного потока публикаций и реакций в рабочий источник инсайтов для маркетинга, продукта и стратегии. Приобрести качественные резидентские и дата-центровые прокси вы можете у нас на сайте node-proxy.com.