Парсинг на Go: Colly, goquery и chromedp через прокси
Go хорошо подходит для парсинга: один скомпилированный файл держит тысячи одновременных запросов и расходует мало памяти. Обычный набор состоит из трёх частей: net/http и goquery скачивают и разбирают статичные страницы, Colly обходит сайт с колбэками, лимитами и пагинацией, а chromedp управляет настоящим Chrome, если данные появляются только после выполнения JavaScript. Все три умеют работать через прокси, а смена IP между запросами занимает несколько строк.
Большинство руководств по парсингу на Go ограничиваются одним примером на Colly. Мы соберём один и тот же небольшой парсер каталога книг тремя способами, подключим прокси с авторизацией на каждом уровне, настроим ротацию выходных IP, аккуратно ограничим параллельность и сохраним результат в CSV и JSON. В конце — таблица типичных ошибок.
Ротируемые прокси для парсеров на Go
Один шлюз для net/http, Colly и chromedp с новым IP на запрос или липкими сессиями
Какую библиотеку выбрать
| Библиотека | Роль | Выполняет JavaScript | Прокси | Когда брать |
|---|---|---|---|---|
net/http (стандартная библиотека) | HTTP-клиент | Нет | Transport.Proxy, адреса HTTP и SOCKS5 | Полный контроль, API, минимум зависимостей |
| goquery | Разбор HTML в стиле jQuery поверх x/net/html | Нет | Не нужен, только разбор | Извлечение полей по CSS-селекторам |
| Colly v2 | Фреймворк обхода: колбэки, лимиты, кеш, асинхронность | Нет | SetProxy, SetProxyFunc, переключатель по кругу | Многостраничный обход, пагинация, переходы по ссылкам |
| chromedp | Управляет Chrome по протоколу DevTools | Да | Опция аллокатора ProxyServer | Страницы на скриптах, клики, прокрутка |
Практичный порядок такой: обход сайта начинаем с Colly, к net/http с goquery переходим, когда нужен точный контроль над запросами, а chromedp берём только для страниц, в исходном HTML которых данных нет. Если вы только знакомитесь с темой, цикл «скачать — разобрать — сохранить» описан в статье о парсинге сайтов.
Подготовка проекта
Установите актуальную версию Go и создайте модуль:
mkdir shelfscout && cd shelfscout
go mod init example.com/shelfscout
go get github.com/gocolly/colly/v2 github.com/PuerkitoBio/goquery github.com/chromedp/chromedp
Тренируемся на books.toscrape.com — учебном магазине, созданном для отработки парсинга. Настройки прокси берём из переменных окружения: в EXIT_URL полный адрес вида http://user:pass@host:port, в EXIT_HOSTPORT — только host:port для браузера.
Шаг 1. net/http и goquery
Стандартный клиент получает прокси через транспорт. http.ProxyURL принимает разобранный URL, а логин и пароль из него автоматически передаются прокси-серверу.
package main

import (
	"fmt"
	"log"
	"net/http"
	"net/url"
	"os"
	"time"

	"github.com/PuerkitoBio/goquery"
)

func newFetcher() *http.Client {
	exit, err := url.Parse(os.Getenv("EXIT_URL"))
	if err != nil {
		log.Fatal(err)
	}
	return &http.Client{
		Timeout: 30 * time.Second,
		Transport: &http.Transport{
			Proxy:               http.ProxyURL(exit),
			MaxIdleConnsPerHost: 4,
		},
	}
}

func main() {
	fetcher := newFetcher()
	req, _ := http.NewRequest("GET", "https://books.toscrape.com/", nil)
	req.Header.Set("User-Agent", "Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36")
	req.Header.Set("Accept-Language", "ru-RU,ru;q=0.9,en;q=0.7")

	resp, err := fetcher.Do(req)
	if err != nil {
		log.Fatal(err)
	}
	defer resp.Body.Close()

	doc, err := goquery.NewDocumentFromReader(resp.Body)
	if err != nil {
		log.Fatal(err)
	}
	doc.Find("article.product_pod").Each(func(_ int, card *goquery.Selection) {
		title, _ := card.Find("h3 a").Attr("title")
		price := card.Find("p.price_color").Text()
		fmt.Printf("%s | %s\n", title, price)
	})
}
В рабочем коде проверяйте resp.StatusCode до разбора: goquery спокойно разберёт и страницу с ошибкой. Тип прокси определяется схемой адреса, поэтому socks5:// тоже работает со стандартным транспортом. Какой протокол заказать у провайдера, поможет решить сравнение SOCKS5 и HTTP-прокси, а как зашифрованный трафик проходит через прокси, объясняет статья про HTTP- и HTTPS-прокси.
Шаг 2. Обход сайта с Colly
Colly прячет цикл запросов за колбэками: OnHTML срабатывает на каждый элемент, подходящий под селектор, а вызов Visit внутри колбэка переходит по ссылке. LimitRule задаёт параллельность и случайную паузу для домена.
package main

import (
	"fmt"
	"log"
	"os"
	"time"

	"github.com/gocolly/colly/v2"
)

type Book struct {
	Title string `json:"title"`
	Price string `json:"price"`
	Link  string `json:"link"`
}

func main() {
	var shelf []Book

	crawler := colly.NewCollector(
		colly.AllowedDomains("books.toscrape.com"),
		colly.UserAgent("Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36"),
	)
	crawler.SetRequestTimeout(30 * time.Second)

	if err := crawler.SetProxy(os.Getenv("EXIT_URL")); err != nil {
		log.Fatal(err)
	}
	crawler.Limit(&colly.LimitRule{
		DomainGlob:  "*",
		Parallelism: 2,
		RandomDelay: 2 * time.Second,
	})

	crawler.OnHTML("article.product_pod", func(card *colly.HTMLElement) {
		shelf = append(shelf, Book{
			Title: card.ChildAttr("h3 a", "title"),
			Price: card.ChildText("p.price_color"),
			Link:  card.Request.AbsoluteURL(card.ChildAttr("h3 a", "href")),
		})
	})
	crawler.OnHTML("li.next a", func(next *colly.HTMLElement) {
		next.Request.Visit(next.Attr("href"))
	})
	crawler.OnError(func(r *colly.Response, err error) {
		log.Printf("failed %s: %d %v", r.Request.URL, r.StatusCode, err)
	})

	crawler.Visit("https://books.toscrape.com/catalogue/page-1.html")
	fmt.Println("books collected:", len(shelf))
}
Здесь коллектор работает синхронно, поэтому добавлять элементы в срез безопасно. Если включить colly.Async(true) ради скорости, защитите общие данные мьютексом и перед чтением результатов вызовите crawler.Wait().
Шаг 3. Ротация прокси в Colly и net/http
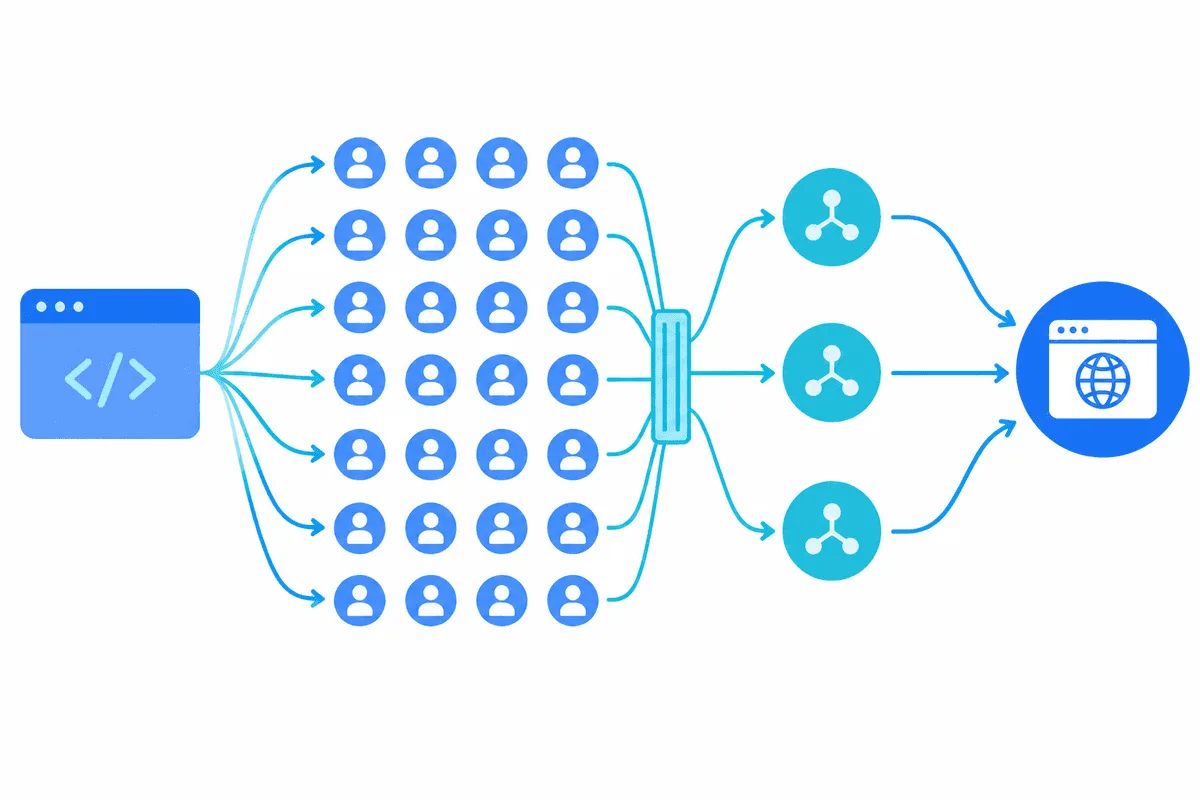
В Colly есть подпакет proxy с переключателем по кругу. Он принимает список адресов прокси и для каждого запроса берёт следующий:
import "github.com/gocolly/colly/v2/proxy"

switcher, err := proxy.RoundRobinProxySwitcher(
	os.Getenv("EXIT_URL_A"),
	os.Getenv("EXIT_URL_B"),
	os.Getenv("EXIT_URL_C"),
)
if err != nil {
	log.Fatal(err)
}
crawler.SetProxyFunc(switcher)
В обычном net/http поле Proxy у транспорта — это функция, так что выход можно выбирать на каждый запрос самостоятельно, например перебирая срез с атомарным счётчиком. На практике ротацию на стороне клиента часто вообще не делают: ротируемый шлюз выдаёт новый IP каждому новому соединению или держит один адрес для липкой сессии — режим задаётся логином или портом. Направьте все клиенты на один адрес ротируемых прокси, и смена IP происходит на стороне шлюза. Когда нужна смена на каждый запрос, а когда на сессию, разобрано в статье о ротации IP.
Помните, что Go переиспользует соединения. При keep-alive несколько запросов могут пройти через один туннель, а значит, через один выходной IP; если нужен новый адрес на каждый запрос, закрывайте простаивающие соединения или отключите keep-alive в транспорте.
Шаг 4. Страницы на JavaScript: chromedp
Если в браузере данные видны, а в скачанном HTML их нет, их дорисовывают скрипты. Сначала откройте DevTools, на вкладке Network включите фильтр Fetch/XHR и поищите JSON-запрос, который можно повторить через net/http, — это гораздо дешевле браузера. Если такого запроса нет, Chrome запускает chromedp.
Пример ниже использует классический API chromedp, который показывают большинство руководств: Run принимает действия и записывает результат в переменные. В README проекта сказано, что новые выпуски (начиная с v0.20) перешли на обобщённый API с итераторами, и дана ссылка на руководство по миграции, поэтому либо закрепите более раннюю версию в go.mod, либо перепишите вызовы по этому руководству.
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"strings"
	"time"

	"github.com/PuerkitoBio/goquery"
	"github.com/chromedp/chromedp"
)

func main() {
	flags := append(chromedp.DefaultExecAllocatorOptions[:],
		chromedp.ProxyServer("http://"+os.Getenv("EXIT_HOSTPORT")),
		chromedp.Flag("blink-settings", "imagesEnabled=false"),
	)
	allocCtx, stopAlloc := chromedp.NewExecAllocator(context.Background(), flags...)
	defer stopAlloc()

	tabCtx, stopTab := chromedp.NewContext(allocCtx)
	defer stopTab()
	tabCtx, stopTimer := context.WithTimeout(tabCtx, 45*time.Second)
	defer stopTimer()

	var markup string
	err := chromedp.Run(tabCtx,
		chromedp.Navigate("https://quotes.toscrape.com/js/"),
		chromedp.WaitVisible("div.quote", chromedp.ByQuery),
		chromedp.OuterHTML("body", &markup, chromedp.ByQuery),
	)
	if err != nil {
		log.Fatal(err)
	}

	page, _ := goquery.NewDocumentFromReader(strings.NewReader(markup))
	page.Find("div.quote span.text").Each(func(_ int, s *goquery.Selection) {
		fmt.Println(s.Text())
	})
}
Логин и пароль во флаге прокси-сервера Chrome игнорирует, поэтому в EXIT_HOSTPORT только хост и порт. Проще всего добавить IP сервера в белый список в кабинете провайдера или поднять локальный пересылающий прокси без пароля, который передаёт трафик на прокси с авторизацией. Можно отвечать на запрос авторизации через домен Fetch протокола DevTools, но такой код зависит от версии chromedp — проверьте его, прежде чем на него полагаться.
Шаг 5. Параллельность без перегрузки сайта
Горутины дешёвые, поэтому ограничение должно исходить от вас. Буферизованный канал работает как семафор и ограничивает число одновременных запросов к сайту:
gate := make(chan struct{}, 4)
var wg sync.WaitGroup

for _, target := range pages {
	wg.Add(1)
	go func(addr string) {
		defer wg.Done()
		gate <- struct{}{}
		defer func() { <-gate }()

		grab(addr)
		time.Sleep(time.Duration(800+rand.Intn(1200)) * time.Millisecond)
	}(target)
}
wg.Wait()
Четыре параллельных запроса со случайной паузой — разумный старт для небольшого сайта. Увеличивайте число, только пока время ответа и коды остаются нормальными, а при ответах 429 отступайте, ориентируясь на заголовок Retry-After. О темпе, заголовках и выборе типа IP подробнее рассказано в статье о прокси для парсинга.
Шаг 6. Сохраняем в CSV и JSON
func saveShelf(shelf []Book) error {
	sheet, err := os.Create("books.csv")
	if err != nil {
		return err
	}
	defer sheet.Close()
	w := csv.NewWriter(sheet)
	w.Write([]string{"title", "price", "link"})
	for _, b := range shelf {
		w.Write([]string{b.Title, b.Price, b.Link})
	}
	w.Flush()
	if err := w.Error(); err != nil {
		return err
	}

	blob, err := json.MarshalIndent(shelf, "", "  ")
	if err != nil {
		return err
	}
	return os.WriteFile("books.json", blob, 0o644)
}
Теги структуры Book задают имена полей в JSON. csv.Writer буферизует вывод, поэтому Flush и проверка ошибки обязательны. Если файл будут открывать в Excel с русской локалью, задайте w.Comma = ';'.
Частые ошибки
| Ошибка | Вероятная причина | Решение |
|---|---|---|
407 Proxy Authentication Required | Неверный логин, спецсимволы не закодированы в URL | Собрать адрес через url.UserPassword, проверить белый список IP |
proxyconnect tcp: ... connection refused | Неверный хост или порт, прокси недоступен | Проверить host:port, попробовать прокси через curl |
Forbidden domain в Colly | Адрес вне AllowedDomains | Добавить домен или проверить, куда ведёт редирект |
context deadline exceeded в chromedp | Селектор так и не появился, медленный прокси | Проверить селектор, увеличить тайм-аут |
| 403 или страница проверки | IP под подозрением, заголовки по умолчанию | Заголовки как у браузера, резидентные IP, медленнее темп |
| Один и тот же IP на все запросы | keep-alive переиспользует туннель | Отключить keep-alive или включить режим смены IP на каждый запрос |
| Пустой результат | Контент рисуют скрипты, страница согласия | Сохранить HTML, искать XHR-запрос или использовать chromedp |
Собирайте только общедоступные данные, до начала работы читайте robots.txt и правила сайта и не храните персональные данные, которые вам не нужны.
Частые вопросы о парсинге на Go
Подходит ли Go для парсинга сайтов?
Да, особенно для крупных обходов. Горутины делают высокую параллельность дешёвой, скомпилированный файл легко развернуть, а Colly, goquery и chromedp закрывают обход, разбор и отрисовку JavaScript, хотя готовых расширений у Python больше.
Чем Colly отличается от goquery?
goquery только разбирает уже полученный HTML и позволяет искать элементы по CSS-селекторам. Colly — фреймворк обхода: он скачивает страницы, переходит по ссылкам, соблюдает лимиты и вызывает ваши обработчики, а для селекторов сам использует goquery.
Как указать прокси в Colly?
Для одного выхода вызовите SetProxy с полным адресом прокси, а для ротации передайте в SetProxyFunc переключатель RoundRobinProxySwitcher из пакета colly/v2/proxy. Логин и пароль пишутся в адресе, например http://user:pass@host:port.
Можно ли на Go парсить сайты на JavaScript?
Да, с помощью chromedp, который управляет настоящим Chrome или Chromium через протокол DevTools. Но сначала проверьте, не берёт ли страница данные из JSON-запроса: обращаться к нему напрямую гораздо быстрее, чем отрисовывать страницу.
Сколько параллельных запросов делать парсеру на Go?
Начните с нескольких на сайт, например двух-четырёх, со случайными паузами и увеличивайте, только пока сервер отвечает быстро и без кодов 429 и 403. Предел задаёт сайт, а не Go.