Прокси в веб-скрейпинге: как выбрать подходящую схему сбора данных и избежать технических сбоев
 ·19 сентября 2026 г.·6 минут чтения
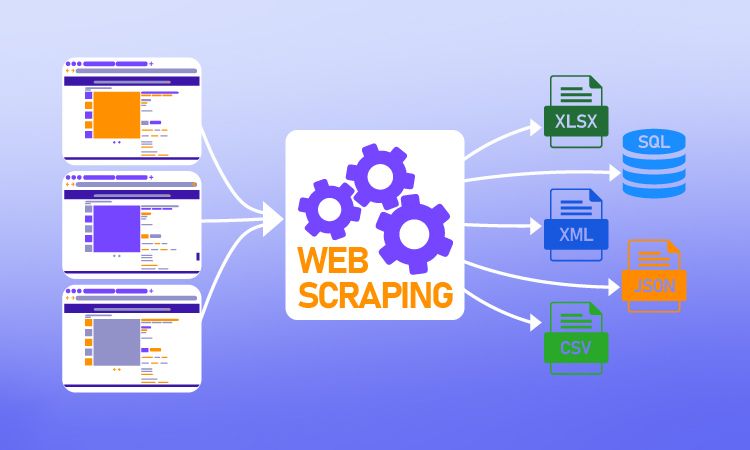
Веб-скрейпинг используют там, где данные нужно собирать регулярно, в большом объёме и из разных источников. Ручной сбор в таких задачах быстро перестаёт работать: он медленный, плохо масштабируется и даёт больше ошибок. Автоматизация решает эту проблему, но вместе с ней появляется другая: сайты отслеживают нетипичную активность, ограничивают частоту запросов и блокируют соединения, если нагрузка выглядит подозрительно. В этой связке прокси становятся не дополнительным инструментом, а одной из базовых частей инфраструктуры сбора данных.
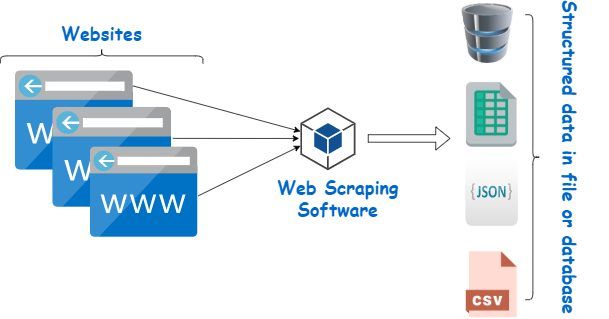
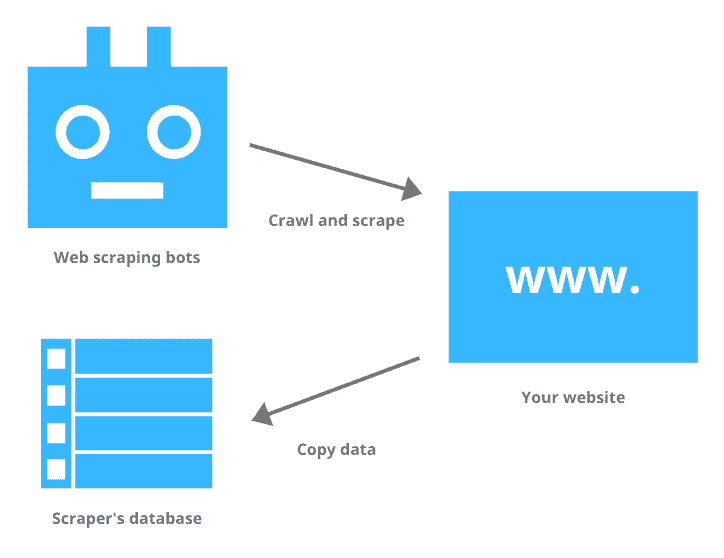
Прокси-сервер выступает промежуточным узлом между скрейпером и целевым сайтом. Запрос сначала проходит через него, и уже затем уходит на нужный ресурс. В результате сайт видит не адрес исходной машины, а IP прокси. Для веб-скрейпинга это важно по нескольким причинам. Во-первых, так проще распределять запросы между разными IP и не упираться в лимиты, связанные с одним адресом. Во-вторых, можно обращаться к сайтам так, будто трафик идёт из конкретного региона. В-третьих, такая схема позволяет строить масштабируемый сбор данных, где нагрузка не концентрируется в одной точке.
Суть здесь в том, чтобы управлять сетевым профилем скрейпера. Если десятки, сотни или тысячи запросов идут подряд с одного IP, это выглядит как автоматизированная активность. Если запросы распределены, частота контролируется, а сама схема обращений устроена аккуратно, вероятность жёстких ограничений заметно ниже. Поэтому прокси в веб-скрейпинге — это прежде всего инструмент распределения нагрузки и управления устойчивостью.
Инфраструктура для скрейпинга
Резидентские и датацентровые прокси для автоматизированного сбора информации из интернета.
Какие задачи решают прокси при сборе данных
Основная задача прокси — снизить риск блокировок при массовом извлечении информации. Сайтам несложно заметить однотипные обращения с одного адреса, особенно если они повторяются с высокой скоростью. Когда запросы идут через пул прокси, нагрузка распределяется, и каждая отдельная точка выглядит менее подозрительно.
Вторая задача — работа с географически зависимым контентом. Многие сайты показывают разное содержимое в зависимости от страны, города или языка пользователя. Это особенно важно для мониторинга цен, локальной выдачи, каталогов товаров, вакансий, транспортных и туристических сервисов. Без прокси в таких сценариях сложно получить данные именно в том виде, в каком их видит пользователь из нужного региона.
Третья задача — масштабирование. Пока проект небольшой, можно обойтись несколькими соединениями и ручной настройкой. Но при росте объёма запросов нужна система, которая умеет менять IP, отслеживать ошибки, перераспределять нагрузку и поддерживать стабильную работу скрейпера в течение длительного времени.
IPv4 и IPv6: что учитывать на практике
При выборе прокси имеет значение не только тип IP, но и версия интернет-протокола. Сегодня используются IPv4 и IPv6. IPv4 по-прежнему остаётся основным стандартом для большинства сайтов и сервисов. Адреса этого формата ограничены по количеству, поэтому они дороже и ценнее в коммерческой прокси-инфраструктуре.
IPv6 предоставляет несопоставимо больший пул адресов, но в веб-скрейпинге его применение зависит не от теоретических преимуществ, а от совместимости целевого сайта. Если ресурс корректно работает с IPv6, такой вариант может снизить затраты на прокси. Но если поддержка ограничена или нестабильна, скрейпер всё равно придётся строить на IPv4. Поэтому выбор между IPv4 и IPv6 — это не вопрос новизны протокола, а вопрос практической совместимости с конкретной целью.
HTTP, HTTPS и SOCKS: чем отличаются прокси-протоколы
Для задач веб-скрейпинга чаще всего используются HTTP-, HTTPS- и SOCKS-прокси. Разница между ними связана не только с форматом передачи данных, но и с тем, какой трафик они обслуживают и как вписываются в архитектуру проекта.
HTTP-прокси подходят для обычного веб-трафика и типовых сценариев, где скрейпер работает через HTTP-запросы к страницам или API. Это распространённый и понятный вариант, особенно если проект опирается на стандартные библиотеки запросов.
HTTPS-прокси работают по тому же принципу, но через защищённое соединение. Если в процессе важна передача данных по шифрованному каналу, такой вариант предпочтительнее.
SOCKS-прокси работают на более низком уровне и поддерживают разные типы трафика, а не только HTTP. Чаще всего используют SOCKS5. Этот протокол удобен там, где нужен более универсальный способ маршрутизации соединений, в том числе для нестандартных сценариев и отдельных видов браузерной автоматизации.
На практике выбор протокола чаще определяется совместимостью со стеком инструментов, чем абстрактными преимуществами. Если библиотека или инфраструктура проще и стабильнее работает с HTTP, в этом нет проблемы. Если нужен более гибкий транспортный слой, имеет смысл смотреть в сторону SOCKS5.
Подробнее о различиях между SOCKS5 и HTTP-прокси, особенностях их работы и выборе подходящего варианта для разных задач мы рассказали в отдельной статье.
Основные типы прокси для веб-скрейпинга
Выбор типа прокси влияет сразу на три параметра: стоимость, вероятность блокировки и стабильность соединения. Универсального варианта нет — подходящий тип определяется характером сайта, объёмом запросов и требованиями к сессии.
Прокси дата-центров
Это самый доступный и обычно самый быстрый тип прокси. Такие IP выдаются из инфраструктуры дата-центров и хорошо подходят для массового сбора данных с сайтов без жёсткой антибот-защиты. Их плюс — высокая скорость, низкая задержка, предсказуемость и сравнительно низкая цена.
Минус в том, что такие адреса чаще распознаются как техническая инфраструктура, а не как обычные пользовательские подключения. Поэтому для чувствительных площадок, где анализируют качество трафика, одного пула дата-центровых прокси часто недостаточно.
Резидентские прокси
Резидентские IP привязаны к адресам, которые интернет-провайдеры выдают обычным пользовательским устройствам. За счёт этого они выглядят для сайтов более естественно и реже попадают под жёсткие ограничения. Именно поэтому их часто используют на площадках с более строгими механизмами защиты.
Но у резидентных прокси есть и обратная сторона: они дороже, а удержание одной и той же сессии может быть менее стабильным, если провайдер строит инфраструктуру на ротации адресов. Это хороший вариант там, где важнее успешность запросов, чем минимальная стоимость каждого соединения.
Статические резидентские или ISP-прокси
Этот вариант часто рассматривают как компромисс между дата-центровыми и резидентными прокси. С одной стороны, такие IP вызывают больше доверия, поскольку связаны с интернет-провайдерами. С другой — они обеспечивают более стабильную работу и предсказуемую сессию, чем типичные ротируемые резидентные адреса.
ISP-прокси подходят для задач, где требуется держать соединение дольше, проходить многошаговые сценарии и при этом не терять в надёжности. Обычно они стоят дороже дата-центровых, но дешевле самых сложных мобильных конфигураций.
Мобильные прокси
Мобильные прокси используют IP, относящиеся к сетям мобильных операторов. Такой трафик часто воспринимается сайтами как менее рискованный, особенно на платформах с выраженной мобильной аудиторией. По этой причине мобильные прокси считаются одним из самых устойчивых вариантов с точки зрения прохождения антибот-фильтров.
Однако они дорогие, не всегда быстрые и хуже подходят там, где нужна долговременная фиксация одной сессии. Их используют точечно — когда обычные схемы уже не дают приемлемого процента успешных запросов или когда цель сильно зависит от мобильного окружения.
Что такое ротация прокси и почему без неё сложно масштабироваться
Даже хороший пул прокси не даёт эффекта сам по себе, если скрейпер использует адреса однообразно. При серьёзной нагрузке нужна ротация IP — смена адреса либо на каждый запрос, либо по определённому правилу: через заданное число обращений, по времени, по типу страницы или при ошибке.
Ротация снижает риск того, что сайт свяжет большой объём активности с одним источником. Это особенно важно при обходе каталогов, карточек товаров, поисковой выдачи, форумов и других больших массивов страниц. Если запросы распределяются по пулу адресов, нагрузка выглядит менее концентрированной, а блокировка одного IP не останавливает весь процесс.
Ротация бывает ручной и автоматической. Ручная настройка годится для тестов, локальных задач и небольших экспериментов. Но как только речь идёт о постоянном сборе данных, без автоматизации не обойтись. Скрейпер должен сам выбирать адрес, отслеживать неудачные попытки, исключать проблемные прокси и повторять запросы по понятным правилам.
Как встроить прокси в скрейпер
Технически интеграция прокси зависит от используемого стека. В простых проектах достаточно указать хост, порт и, при необходимости, параметры аутентификации в настройках HTTP-клиента. Так можно подключить прокси к запросам в Python, Node.js и других популярных средах.
Но сама по себе подстановка прокси в запрос — только базовый уровень. Для устойчивой работы обычно требуется отдельная логика управления пулом: выбор адреса, контроль числа попыток, обработка тайм-аутов, переиспользование соединений, сбор статистики по успешности и исключение нестабильных узлов. Без этого даже дорогой прокси-пул быстро превращается в источник сбоев.
Если сайт отдаёт контент только после выполнения JavaScript, одних HTTP-запросов может быть недостаточно. В таких случаях подключают headless-браузеры. Они позволяют дождаться полной отрисовки страницы, выполнить клиентские сценарии и извлечь данные уже после загрузки динамических элементов. Но у браузерной автоматизации есть цена: она заметно тяжелее по трафику и ресурсам, а значит, требования к прокси и бюджету здесь выше.
Почему блокировки возникают даже при наличии прокси
Распространённая ошибка — считать, что наличие прокси автоматически решает проблему обнаружения. На практике сайты анализируют не только IP, но и общее поведение запросов. Даже хороший адресный пул не спасёт, если скрейпер обращается к сайту слишком быстро, всегда с одинаковыми заголовками, без пауз, без cookies и без логики, похожей на реальную пользовательскую сессию.
Чтобы снизить риск ограничений, обычно применяют сразу несколько мер:
• добавляют случайные задержки между запросами;
• меняют user-agent и другие заголовки;
• распределяют обращения между адресами и не перегружают один IP;
• корректно работают с cookies и сессионными данными;
• следят за кодами ответа и уменьшают интенсивность при признаках ограничения;
• не обращаются без необходимости к страницам с повышенной защитой или сложными многошаговыми сценариями.
Если сервер начинает отвечать ошибками, выдавать CAPTCHA или возвращать 429 Too Many Requests, это сигнал не только о проблеме с IP, но и о том, что нужно пересмотреть поведение скрейпера в целом.
CAPTCHA, антибот-механизмы и поведенческие сигналы
Современные сайты ограничиваются не только базовой фильтрацией по IP. Они проверяют поведение клиента, последовательность действий, профиль браузера, характер заголовков, устойчивость сессии и другие признаки автоматизации. Поэтому прокси — только часть решения.
На практике помогает не агрессивное наращивание адресов, а более аккуратная архитектура запросов. Чем меньше скрейпер отличается от предсказуемого браузерного сценария, тем выше шанс стабильной работы. Для динамических и защищённых сайтов этого часто недостаточно, поэтому в ход идут headless-браузеры, управление отпечатком браузера, корректная работа с cookies и повторные попытки по адаптивным правилам.
Важно и то, что CAPTCHA не стоит рассматривать как отдельную проблему. Чаще это следствие того, что сайт уже распознал подозрительную схему взаимодействия. Поэтому эффективнее не бороться с каждой CAPTCHA отдельно, а снижать вероятность их появления за счёт скорости, ротации, качества IP и общей правдоподобности запросов.
Бюджет и пропускная способность: где обычно недооценивают расходы
Стоимость прокси в веб-скрейпинге зависит не только от цены тарифа, но и от того, сколько трафика потребляет сам проект. Это особенно заметно на динамических сайтах, в браузерной автоматизации и на страницах с большим количеством изображений, скриптов и вспомогательных ресурсов.
Если скрейпер забирает только нужный HTML или точечные данные из API, расход может оставаться умеренным. Если же проект использует headless-браузер и загружает полноценные страницы со всеми ресурсами, объём трафика вырастает кратно. В результате дешёвый на первый взгляд прокси-тариф может оказаться дорогим в реальной эксплуатации.
Снизить расходы помогают несколько практических мер: запрашивать только нужные страницы, не загружать повторно уже обработанные данные, кэшировать результаты, отключать ненужные ресурсы в браузере, фильтровать изображения и тяжёлые элементы, использовать сжатие ответов там, где это возможно. При росте проекта эти мелочи начинают напрямую влиять на бюджет.
Типовые проблемы при работе с прокси
Даже правильно подобранные прокси не избавляют от технических сбоев. Самые частые проблемы — тайм-ауты, ошибки аутентификации, нестабильная скорость, ограничение параллельных соединений и падение процента успешных запросов.
Тайм-ауты обычно указывают либо на перегруженный прокси, либо на слишком медленный маршрут до целевого сайта. В таком случае приходится либо менять пул, либо корректировать настройки ожидания и повторных попыток.
Ошибки аутентификации чаще всего связаны с неверными учётными данными, неправильно собранной строкой подключения или ошибками в формате конфигурации.
Низкая успешность запросов — более сложная проблема. Она может означать слабое качество IP, слишком однообразное поведение скрейпера, неправильную ротацию, чрезмерную скорость обращений или несовместимость между типом прокси и задачей. Здесь редко помогает одна точечная правка: обычно нужно одновременно смотреть на сетевой слой, логику запросов и профиль целевого сайта.
Бесплатные и платные прокси: что выгоднее на практике
Бесплатные прокси кажутся удобной точкой входа, но в реальных проектах почти всегда проигрывают платным по совокупной стоимости. Их главная проблема не только в низкой скорости или частых блокировках, а в непредсказуемости. Сегодня адрес работает, завтра — нет. Кроме того, такие прокси часто уже известны сайтам, используются слишком большим числом людей и не дают стабильной успешности.
Для теста идеи или учебного примера этого может хватить. Но как только задача становится регулярной, инженерные затраты на проверку, замену и поддержку бесплатных списков перекрывают любую формальную экономию. Платные прокси дороже на входе, но дают более предсказуемую работу, геотаргетинг, поддержку, контроль качества и в итоге требуют меньше ручного вмешательства.
Когда лучше использовать не только прокси, но и готовые сервисы скрейпинга
В некоторых проектах сложность начинает накапливаться быстрее, чем растёт сам объём данных. Нужно поддерживать ротацию, разбираться с CAPTCHA, учитывать JavaScript-рендеринг, следить за сессиями, обновлять отпечатки браузера и параллельно контролировать бюджет. В таких случаях компании нередко переходят от простого пула прокси к специализированным сервисам скрейпинга, которые берут часть инфраструктурных задач на себя.
Такой подход удобен, когда важно не столько самостоятельно управлять каждым сетевым слоем, сколько получать предсказуемый результат. Но здесь всё зависит от задачи. Если у команды есть сильная инженерная база и понятная цель с устойчивыми требованиями, собственная инфраструктура на прокси может быть оправдана. Если же приоритет — быстрое внедрение и снижение операционной сложности, готовый сервис оказывается практичнее.
Как выбирать прокси под конкретный проект
Выбор прокси не стоит сводить к рейтингу провайдеров или к общей формуле «чем дороже, тем лучше». Намного полезнее отталкиваться от сценария.
Если нужно собирать публичные данные с относительно простых сайтов в большом объёме, часто достаточно дата-центровых прокси с грамотной ротацией и нормальной системой повторных попыток.
Если сайт чувствителен к качеству трафика, анализирует поведение и жёстко ограничивает автоматизацию, стоит смотреть в сторону резидентных или ISP-прокси.
Если критична геолокация, важно проверить, есть ли у провайдера адреса в нужных странах или городах и насколько стабильно они работают в этих регионах.
Если проект строится на headless-браузерах, нужно заранее оценивать не только цену IP, но и объём трафика, параллелизм, стабильность сессий и поддержку нужных протоколов.
Итог
Прокси в веб-скрейпинге нужны не сами по себе, а как часть управляемой системы сбора данных. Они помогают распределять нагрузку, снижать вероятность блокировок, работать с географически зависимым контентом и масштабировать проект без опоры на один IP-адрес. Но устойчивость скрейпера определяется не только типом прокси. На неё влияют частота запросов, ротация, обработка ошибок, работа с сессиями, загрузка динамического контента и общий профиль поведения клиента.
Для простых задач могут подойти дата-центровые прокси и базовая ротация. Для более требовательных сайтов обычно нужны резидентные или ISP-решения, а иногда и полноценные сервисы скрейпинга с встроенной защитой от типовых ограничений. Правильный выбор здесь строится не вокруг модных категорий, а вокруг конкретной нагрузки, типа сайта и требований к стабильности.