robots.txt и парсинг: как проверить, можно ли парсить сайт
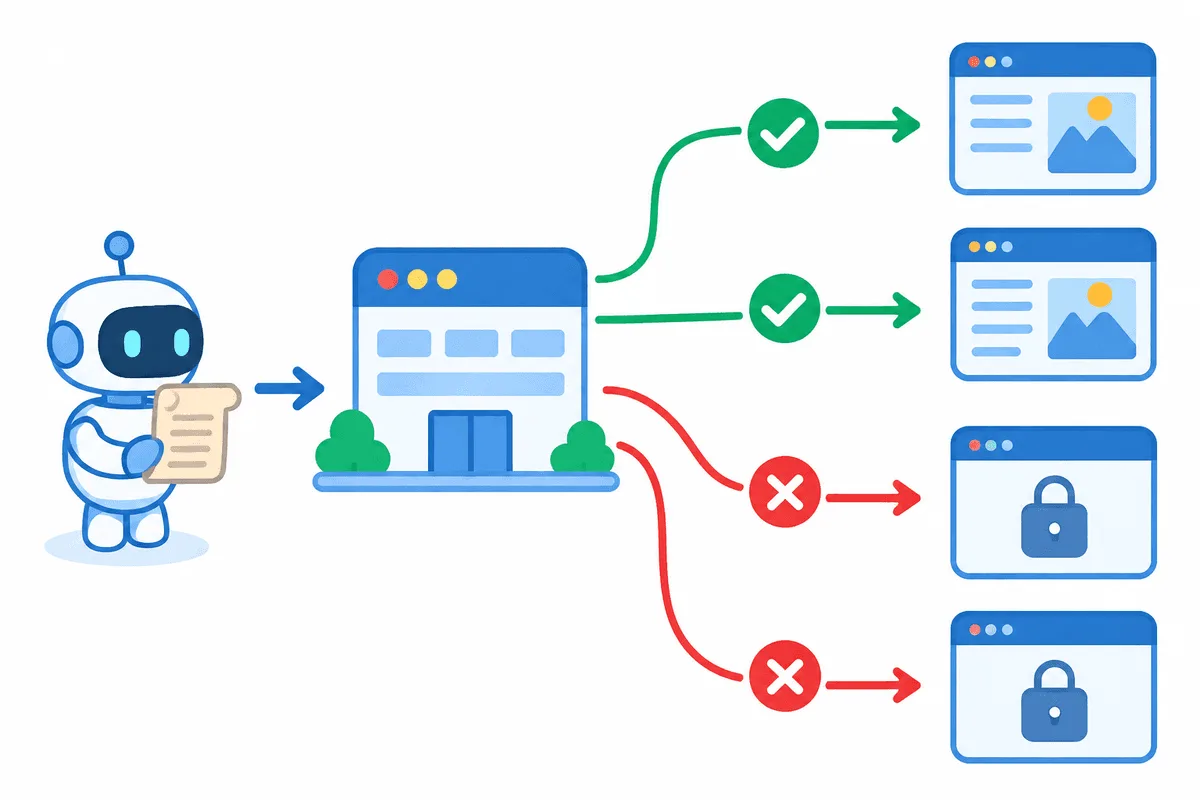
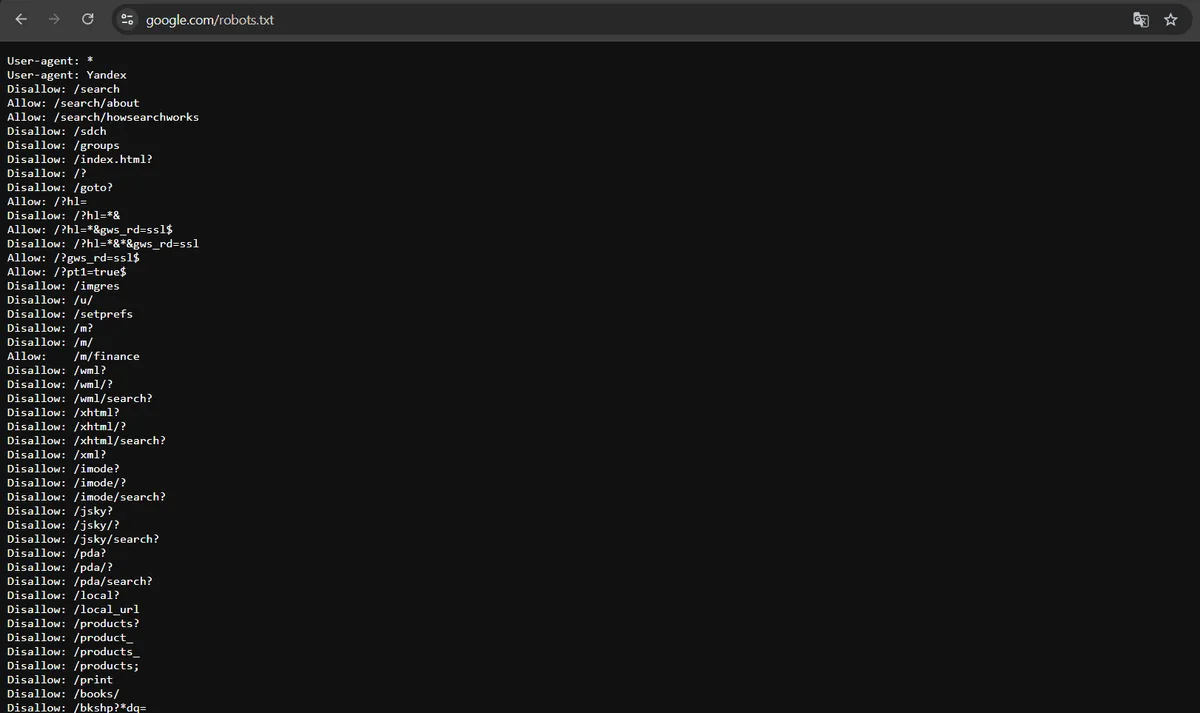
robots.txt — это текстовый файл в корне сайта, в котором владелец указывает автоматическим клиентам, какие разделы можно загружать, а какие нет. С него стоит начинать проверку, разрешён ли парсинг, но окончательного ответа он не даёт: robots.txt — добровольное соглашение, а не замок и не лицензия, и правила сервиса, лимиты запросов и законы о данных значат не меньше.
Разберём, как правильно читать файл, включая моменты, в которых чаще всего ошибаются: приоритет правил, подстановочные знаки, коды ответа и директивы, которые Google не учитывает. Покажем проверку адресов на Python, расскажем, как сайты обращаются к ИИ-краулерам в 2026 году, и что ещё проверить до первого запроса. В конце — чек-лист, который можно применять к каждому новому сайту.
Прокси для аккуратного парсинга
Распределяйте разрешённые запросы по стабильным IP и смотрите страницы глазами пользователей нужной страны
Что такое robots.txt и чем он не является
Протокол исключений для роботов появился в 1994 году, а в сентябре 2022-го стал стандартом IETF под номером RFC 9309. Файл всегда лежит по адресу /robots.txt в корне хоста и действует только для этого сочетания протокола, хоста и порта. У поддомена вроде shop.example.com свой файл, отдельный от www.example.com.
Что делает файл:
- указывает, какие пути не стоит загружать конкретному роботу или всем роботам сразу;
- часто содержит ссылки на карты сайта — удобный список страниц, которые владелец хочет показать;
- иногда включает нестандартные подсказки, например задержку между запросами.
Чего он не делает:
- ничего не блокирует технически: клиент, который его игнорирует, всё равно скачает страницы;
- не выдаёт разрешений: строка
Allowне отменяет пользовательское соглашение, авторское право и законы о персональных данных; - не управляет индексацией: попадёт ли страница в поиск, решают мета-тег
noindexили заголовокX-Robots-Tag, а не robots.txt.
Как читать файл
robots.txt состоит из групп. Каждая группа начинается с одной или нескольких строк User-agent и содержит правила Allow и Disallow. Пример с типичными конструкциями:
User-agent: *
Disallow: /cart/
Disallow: /search
Disallow: /*?sessionid=
Allow: /search/help
Crawl-delay: 5

User-agent: GPTBot
Disallow: /

User-agent: PartnerFeedBot
Allow: /

Sitemap: https://www.example.com/sitemap-index.xml| Строка | Значение |
|---|---|
User-agent: * | Группа для всех роботов, у которых нет своей группы |
Disallow: /cart/ | Не загружать ничего внутри /cart/ |
Disallow: /search | Закрывает и /search, и /search/, и /searchable: правила работают как префиксы |
Disallow: /*?sessionid= | * означает любую последовательность символов |
Allow: /search/help | Исключение внутри закрытого раздела |
Crawl-delay: 5 | Нестандартная подсказка о паузе в секундах |
User-agent: GPTBot + Disallow: / | Этому роботу нельзя загружать ничего |
Sitemap: | Адрес карты сайта, не зависит от групп |
Четыре правила вызывают больше всего путаницы:
- Одна группа на робота. Робот выполняет только ту группу, которая называет его точнее всего, и в этом случае игнорирует группу
*. В примереPartnerFeedBotможет загружать корзину, потому что его собственная группа разрешает всё. - Побеждает самое длинное совпадение. Если к адресу подходят и
Allow, иDisallow, по RFC 9309 действует правило с большим числом символов, а при равенстве —Allow. Порядок строк в файле значения не имеет. $обозначает конец адреса.Disallow: /*.pdf$закрывает адреса, оканчивающиеся на.pdf, но не/file.pdf?v=2.- Пути чувствительны к регистру, а имена роботов сравниваются без учёта регистра.
Директивы вне стандарта
Crawl-delay не входит в RFC 9309. Google её не учитывает, а некоторые другие поисковики, например Bing и Яндекс, исторически её поддерживали. Для парсера задержка всё равно полезна как сигнал о темпе, который владелец считает приемлемым, и соблюдать её почти ничего не стоит. Clean-param и Host — директивы Яндекса, обычному парсеру их можно не учитывать.
Если файла нет или он не открывается
RFC 9309 описывает и поведение при ошибках загрузки robots.txt:
- ответ 4xx (например, 404): файл считается недоступным, и робот может обходить сайт без ограничений robots.txt;
- ответ 5xx или сетевая ошибка: файл недостижим, и робот должен считать закрытым всё, пока не сможет его прочитать;
- кеширование: копию файла не стоит использовать дольше 24 часов, если только сам файл не недостижим.
Стандарт также требует, чтобы парсеры обрабатывали минимум 500 кибибайт файла. Google описывает это как ограничение размера и игнорирует всё, что идёт дальше.
Как проверить robots.txt на Python
В стандартной библиотеке Python есть готовый разборщик. Небольшая функция отвечает, можно ли конкретному роботу загрузить адрес, и возвращает задержку и карты сайта:
from urllib.robotparser import RobotFileParser
from urllib.parse import urlsplit

BOT_NAME = "AcmePriceWatch/1.2 (+https://acme.example/bot)"
BOT_TOKEN = "AcmePriceWatch"

def robots_verdict(page_url: str) -> dict:
    parts = urlsplit(page_url)
    rules = RobotFileParser()
    rules.set_url(f"{parts.scheme}://{parts.netloc}/robots.txt")
    rules.read()
    return {
        "allowed": rules.can_fetch(BOT_TOKEN, page_url),
        "delay": rules.crawl_delay(BOT_TOKEN),
        "sitemaps": rules.site_maps(),
    }

print(robots_verdict("https://books.toscrape.com/catalogue/page-2.html"))
Полное имя BOT_NAME отправляйте в заголовке User-Agent, чтобы владелец сайта понимал, кто к нему пришёл, и мог с вами связаться, а правила проверяйте по короткому токену. Учтите: стандартный разборщик Python применяет правила в порядке их следования в файле, а не по принципу самого длинного совпадения из RFC 9309, поэтому на файлах с пересекающимися Allow и Disallow ответ может отличаться. Scrapy по умолчанию использует разборщик Protego, который старается точнее следовать современным правилам; для боевых краулеров отдельная библиотека надёжнее.
ИИ-краулеры и robots.txt в 2026 году
С 2023 года многие сайты добавили отдельные группы для ИИ-роботов. Чаще всего встречаются GPTBot и OAI-SearchBot (OpenAI), ClaudeBot (Anthropic), Google-Extended (управляющий токен для ИИ-моделей Google, а не отдельный робот), Applebot-Extended, CCBot (Common Crawl), PerplexityBot и Bytespider. Компании время от времени переименовывают и добавляют роботов, поэтому сверяйтесь с актуальной документацией каждой из них, а не со старыми списками.
Стоит знать ещё о двух новых слоях. В 2025 году Cloudflare предложила строку Content-Signal, в которой сайт может указать, например, что разрешает поиск, но не обучение ИИ; это выражение намерений, и в RFC 9309 такой директивы нет. Кроме того, в IETF идёт работа над словарём предпочтений для использования контента ИИ. Основы от этого не меняются: если вы собираете страницы для датасета или RAG-системы, дайте краулеру собственное имя, соблюдайте группы для ИИ-роботов и считайте заявленные запреты на обучение частью правил сайта. Как строятся такие конвейеры, рассказано в статье о парсинге с помощью ИИ.
Что проверить помимо robots.txt
| Проверка | Где смотреть | Что это даёт |
|---|---|---|
| Пользовательское соглашение | Ссылки в подвале: «Условия», «Правила», «Оферта» | Ограничен ли автоматический доступ, обход или повторное использование контента |
| Официальный API или выгрузка | Разделы для разработчиков, партнёров, API | Разрешённый способ получить данные, обычно с понятными лимитами |
| Вход по логину | Видны ли данные без аккаунта | Данные за авторизацией обычно парсить нельзя |
| Лимиты запросов | Ответы 429, заголовки Retry-After и лимитов | Темп, который выдерживает сервер |
| Персональные данные | Имена, контакты, профили на страницах | Обязанности по 152-ФЗ, GDPR и аналогам: минимизировать, защищать, обосновывать |
| Авторское право и базы данных | Тип контента, страна | Повторное использование и публикация могут быть ограничены, даже если загрузка разрешена |
Правовая картина отличается от страны к стране и продолжает меняться. В ЕС исключение для анализа текстов и данных позволяет правообладателям оговорить свои права машиночитаемым способом, и robots.txt часто называют одним из таких способов. В США решения судов о парсинге публичных страниц неоднозначны и зависят от обстоятельств. В России отдельного закона о парсинге нет, но действуют нормы о персональных данных, авторском праве и правах изготовителя базы данных. Игнорирование robots.txt само по себе не делает сбор незаконным, а соблюдение не делает его автоматически законным. Для коммерческих задач консультируйтесь с юристом, который знает вашу юрисдикцию. Технические причины блокировок по ходу работы разобраны в статье об ошибках при парсинге сайтов.
Чек-лист перед парсингом
- Загрузите
/robots.txtдля каждого хоста, к которому будете обращаться, включая поддомены, и найдите группу для своего робота. - Проверьте разборщиком конкретные шаблоны адресов, включая параметры запроса.
- Прочитайте пользовательское соглашение и поищите в нём упоминания автоматического доступа, обхода, парсинга и роботов.
- Поищите официальный API, выгрузку или лицензию на данные.
- Убедитесь, что данные публичны и доступны без входа в аккаунт.
- Отметьте персональные данные на страницах и решите, нужны ли они вообще.
- Задайте осторожную частоту запросов, соблюдайте задержку и
Retry-After, тяжёлые задачи запускайте в часы низкой нагрузки. - Представьтесь понятным User-Agent с адресом для связи.
- При долгом обходе перечитывайте robots.txt хотя бы раз в сутки.
- Ведите журнал: что и когда проверили.
Где здесь прокси
Прокси не меняют того, что разрешает сайт. В корректной схеме у них практическая роль: распределять разрешённые запросы, чтобы ни один адрес не перегружал сервер, видеть страницы так, как их видят пользователи в нужной стране, и держать длинные задачи стабильными. Для открытых данных, сбор которых разрешён, часто достаточно серверных прокси; для потребительских площадок с контентом, зависящим от региона, лучше подходят резидентные IP. Использовать прокси, чтобы массово обходить закрытые в robots.txt разделы, — ровно то, от чего защищает этот чек-лист. Подробности настройки — в статьях о прокси для парсинга и о парсинге сайтов в целом.
Частые вопросы о robots.txt и парсинге
Делает ли robots.txt парсинг законным или незаконным?
Сам по себе — нет. Это добровольный стандарт, в котором владелец выражает пожелания; законность зависит от пользовательского соглашения, типа данных и законов конкретной страны, хотя суды и правила ЕС могут учитывать robots.txt как значимый сигнал.
Что делать, если у сайта нет robots.txt?
Если файл отвечает кодом 404, по стандарту у сайта нет ограничений на обход. Пользовательское соглашение, правила о персональных данных и лимиты запросов всё равно нужно проверить до начала сбора.
Убирает ли Disallow страницы из поиска Google?
Не гарантированно. Disallow запрещает обход, но закрытый адрес может попасть в индекс по ссылкам; чтобы страницы не было в выдаче, используют мета-тег или заголовок noindex на странице, которую роботу разрешено загружать.
Обязательно ли соблюдать Crawl-delay?
Эта директива не входит в официальный стандарт, и Google её игнорирует, но она показывает темп, который владелец считает приемлемым. Соблюдать её — простой способ снизить нагрузку и вероятность блокировки.
Как сайты закрываются от ИИ-краулеров?
Чаще всего добавляют в robots.txt группу для каждого ИИ-робота, например GPTBot или ClaudeBot, с правилами Disallow; некоторые дополнительно указывают сигналы о контенте или блокируют запросы на уровне сети. Актуальные имена роботов смотрите в документации компаний.