Парсинг Reddit: Data API, JSON-эндпоинты или HTML
Данные Reddit лучше всего собирать через официальный Reddit Data API: он отдаёт посты, комментарии и сведения о сабреддитах в аккуратном JSON, бесплатен для небольших некоммерческих проектов в пределах поминутного лимита, а с конца 2025 года новые приложения проходят проверку перед выдачей доступа. Ещё два способа — дописать .json к адресу страницы или разбирать HTML — работают хуже: они хрупкие, сильнее ограничены и плохо сочетаются с правилами Reddit. Поэтому это запасные варианты для небольших разовых выборок.
Обычно статьи на эту тему просто выдают скрипт. Здесь мы сравним все три пути, разберём правила и лимиты, которые изменились после 2023 года, покажем пример чтения через API без входа в чей-либо аккаунт и объясним, где уместны прокси, когда публичные страницы просматриваются в спокойном темпе.
Ротируемые прокси для публичных данных
Ротируемые прокси, чтобы распределять небольшие выборки публичных страниц по адресам в спокойном темпе
Три способа получить данные Reddit
| Критерий | Data API (OAuth) | JSON-эндпоинты | Парсинг HTML |
|---|---|---|---|
| Формат | Структурированный JSON | Структурированный JSON | Разметка, которая меняется |
| Доступ | Зарегистрированное приложение, проверка для новых | Без регистрации | Без регистрации |
| Лимит | Опубликованный поминутный лимит на приложение | Гораздо ниже, считается по IP | Ограничения по IP, страницы проверки |
| Стабильность | Высокая, есть версии | Средняя, доступ могут ограничить в любой момент | Низкая, вёрстка меняется |
| Правила | Условия Data API | Серая зона, правила Reddit о контенте действуют | Ограничено пользовательским соглашением |
| Для чего | Исследования, мониторинг, инструменты модерации | Быстро посмотреть пару тредов | Почти ничего, что не умеют первые два |
Порядок очевиден: сначала API, JSON — чтобы быстро заглянуть, HTML — только если у данных нет другого источника.
Что изменилось: политика данных Reddit после 2023 года
В 2023 году Reddit сделал API платным для крупных и коммерческих пользователей, оставив бесплатный уровень для небольших некоммерческих проектов. Обычно его описывают так: 100 запросов в минуту на один OAuth-клиент с усреднением за десятиминутное окно и заметно меньший лимит для запросов без авторизации. Коммерческое использование, в том числе обучение ИИ-моделей на контенте Reddit, требует отдельного договора с компанией.
Для тех, кто собирает данные, важны ещё два момента:
- Проверка приложений. По сообщениям конца 2025 года, появилась проверка: разработчик подаёт заявку на доступ к API и описывает задачу, прежде чем получить ключи. Закладывайте время на ожидание.
- Жёсткая позиция. В 2024 году Reddit закрыл большую часть сайта для краулеров в robots.txt и обращался в суд против компаний, которых обвинял в массовом парсинге. Масштабный сбор контента в обход API — реальный юридический риск, а не теория.
Цифры и процедуры меняются, поэтому перед стартом прочитайте актуальные Data API Terms, Developer Terms и объявления в r/redditdev.
Способ 1. Официальный Data API
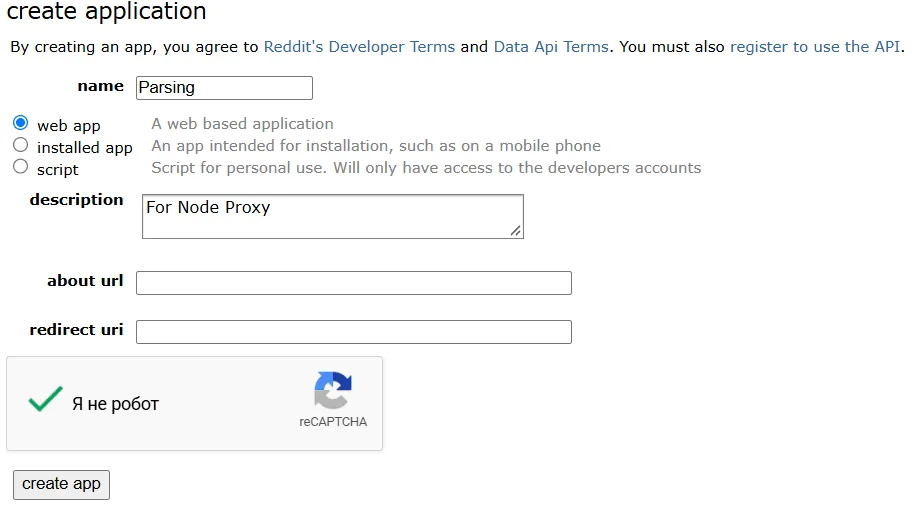
Шаг 1. Зарегистрируйте приложение
Войдите в свой аккаунт Reddit в обычном браузере, откройте в настройках страницу приложений и создайте приложение типа script. Вы получите client ID и client secret. Описание заполните честно: что собираете и зачем.
Шаг 2. Читайте публичные данные в режиме read-only
PRAW (Python Reddit API Wrapper) берёт на себя авторизацию и сам учитывает заголовки лимитов. Если передать только client ID и secret, библиотека работает в режиме только чтения, и скрипт ни разу не входит от имени пользователя.
import os, praw

reddit = praw.Reddit(
    client_id=os.environ["RD_APP_ID"],
    client_secret=os.environ["RD_APP_SECRET"],
    user_agent="python:topic-monitor:v0.3 (by u/your_research_account)",
)

rows = []
for post in reddit.subreddit("homeautomation").top(time_filter="week", limit=50):
    rows.append({
        "id": post.id,
        "title": post.title,
        "score": post.score,
        "comments": post.num_comments,
        "created": post.created_utc,
        "link": f"https://www.reddit.com{post.permalink}",
    })
print(len(rows), rows[0]["title"])
Пояснения к коду:
- User-Agent должен быть уникальным и понятным — в формате, который просит Reddit: платформа, название приложения, версия и контакт. Общие или маскирующиеся под браузер агенты получают ограничения.
- Ключи приложения храните в переменных окружения.
- Сохраняйте идентификаторы постов, а не имена пользователей, если анализу они не нужны.
Шаг 3. Соблюдайте лимиты
В каждом ответе API есть заголовки: сколько запросов осталось и когда обнулится окно. PRAW ждёт автоматически, а если вы обращаетесь к API напрямую, читайте эти заголовки и делайте паузу, когда остаток мал. Комментарии больших тредов подгружаются частями, так что один тред с тысячами комментариев может стоить множества запросов.
Способ 2. JSON-эндпоинты
Если дописать .json к адресу большинства списков или тредов Reddit, вернутся те же данные, которыми пользуется сам сайт. Это удобно, чтобы быстро заглянуть:
import httpx, time

ua = {"User-Agent": "python:thread-sample:v0.1 (by u/your_research_account)"}
link = "https://www.reddit.com/r/homeautomation/top.json?t=week&limit=25"
reply = httpx.get(link, headers=ua, timeout=30, follow_redirects=True)
if reply.status_code == 429:
    time.sleep(120)            # отступить и повторить намного позже или закончить на сегодня
else:
    for child in reply.json()["data"]["children"]:
        print(child["data"]["score"], child["data"]["title"])
Лимиты для JSON-запросов без авторизации намного ниже, чем у API, и считаются по IP-адресу. К тому же Reddit может ограничить или закрыть такой доступ без предупреждения, поэтому продукт на нём не строят. Для всего регулярного переходите на API.
Способ 3. HTML-страницы и место прокси
Парсить HTML-страницы Reddit имеет смысл только ради редких публичных сведений, которых нет в API и JSON, и только в малых объёмах. Пользовательское соглашение Reddit ограничивает автоматический сбор без разрешения, так что оставайтесь в масштабе исследовательской выборки и сначала прочитайте правила.
Если вы всё же просматриваете публичные страницы, практическим ограничением становятся лимиты на IP. Пул ротируемых прокси распределяет небольшое число запросов по адресам, чтобы один IP не упирался в потолок, — это вопрос вежливости, а не скорости. Правила, при которых такая выборка остаётся допустимой:
- Только публичные страницы без входа. Никакой авторизации, закрытых сообществ и сообществ в карантине, никакой автоматизации аккаунтов.
- Один запрос раз в несколько секунд с каждого адреса, случайные паузы, никаких параллельных залпов.
- Немедленная остановка при ответе 429, странице проверки или уведомлении о блокировке. Не решайте капчи и не пытайтесь их обойти.
- Собирайте только нужные поля и ничего лишнего.
Если задача не сбор данных, а работа с настоящими аккаунтами бренда на Reddit, читайте отдельный материал о прокси для Reddit. Общие советы о ротации, сессиях и размере пула — в статье о прокси в веб-скрапинге.
Персональные данные и этика
Посты Reddit публичны, но их пишут люди, и имя пользователя вместе с историей постов может указать на конкретного человека. По GDPR, а в применимых случаях и по российскому 152-ФЗ, для сбора и хранения таких данных нужны правовое основание и меры защиты.
- Собирайте под конкретную цель и храните только нужные для неё поля.
- В исследовательских наборах псевдонимизируйте имена пользователей или удаляйте их.
- Уважайте удаления: если пост удалён на Reddit, уберите его и из своей копии при обновлении данных.
- Не публикуйте заново целые треды и профили отдельных пользователей.
Как те же правила работают на других площадках, сравнивает обзор о сборе данных из социальных сетей.
Частые ошибки
| Ошибка | Что значит | Что делать |
|---|---|---|
| 401 Unauthorized | Неверные данные приложения или истёк токен | Проверить ID и secret, запросить новый токен |
| 403 Forbidden | Закрытое, забаненное или карантинное сообщество либо заблокированный клиент | Пропустить сообщество, проверить User-Agent |
| 429 Too Many Requests | Достигнут лимит | Дождаться обнуления окна, снизить темп |
| Пустые списки | Неверная сортировка или фильтр по времени | Проверить параметры t и limit |
Частые вопросы о парсинге Reddit
Законно ли парсить Reddit?
Самый безопасный способ — официальный Data API в рамках его условий. Сбор страниц в обход API ограничен пользовательским соглашением Reddit, а против масштабных парсеров компания обращалась в суд, поэтому выборку страниц держите небольшой и некоммерческой и соблюдайте законы о персональных данных.
Reddit API бесплатный?
Есть бесплатный уровень для некоммерческих и небольших проектов — обычно называют 100 запросов в минуту на приложение. Коммерческое использование и большие объёмы требуют платного договора с Reddit, а новые приложения теперь проходят проверку.
Нужно ли входить в аккаунт, чтобы собирать данные Reddit?
Нет. Зарегистрированное приложение читает публичные посты и комментарии в режиме только чтения со своими ключами. Автоматизировать вход в пользовательский аккаунт ради сбора не нужно, и это противоречит правилам.
Что даёт .json в конце адреса Reddit?
Страница возвращает свои данные в формате JSON — удобно, чтобы быстро посмотреть несколько тредов. Лимиты низкие и считаются по IP, а доступ могут ограничить в любой момент, поэтому для регулярного сбора это не подходит.
Нужны ли прокси для парсинга Reddit?
Для официального API — нет: его лимит считается на приложение, а не на адрес. Прокси помогают только при выборке публичных страниц, когда небольшое число запросов распределяют так, чтобы один IP не попал под ограничения.
Как избежать ошибки 429 на Reddit?
Читайте заголовки лимитов, делайте паузу при малом остатке квоты и используйте понятный User-Agent. Если 429 всё равно приходит, дождитесь обнуления окна, а не добавляйте параллельные запросы.