Парсинг отзывов: как собирать отзывы с маркетплейсов, карт и сайтов-отзовиков через прокси
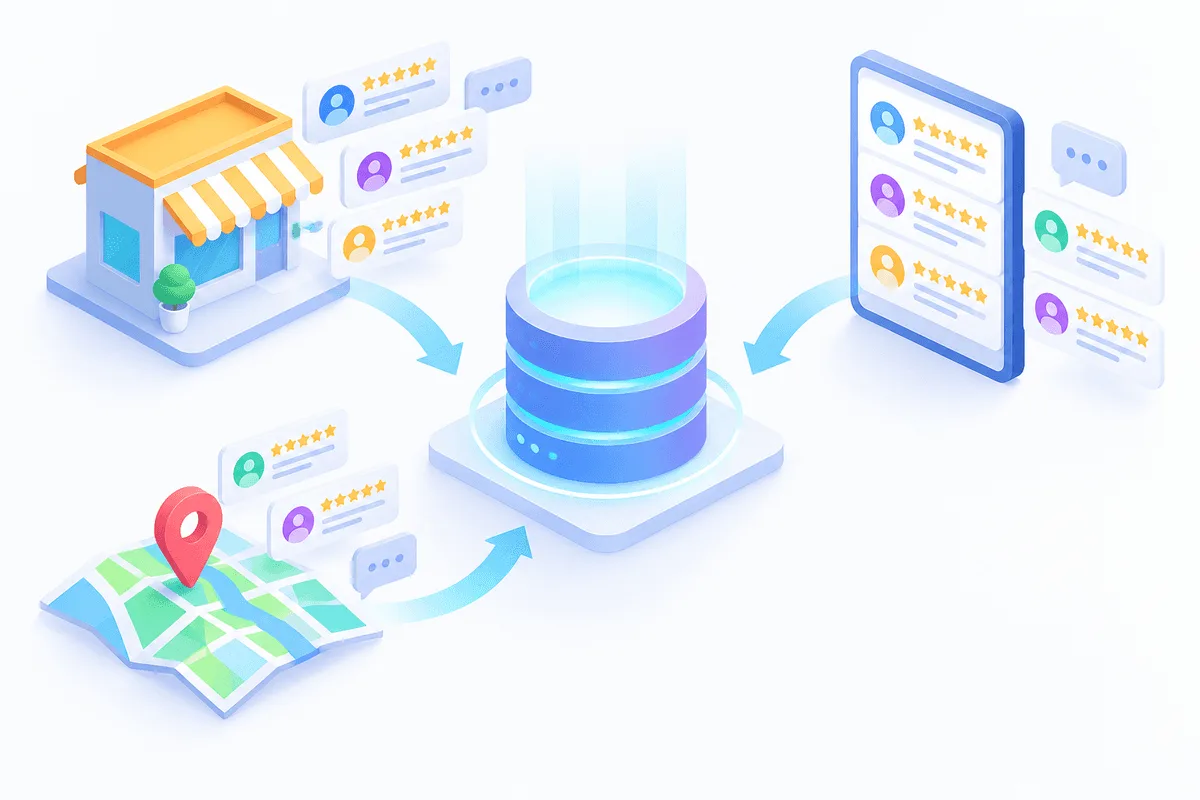
Парсинг отзывов — это автоматический сбор публичных отзывов покупателей с маркетплейсов, карточек организаций на картах и сайтов-отзовиков, после которого оценки, даты и тексты превращаются в таблицу для анализа. Техническая часть несложная: найти, откуда страница подгружает отзывы, пройти все страницы или курсоры, сохранить каждый отзыв ровно один раз и распределить запросы по времени, а при необходимости — по нескольким IP-адресам.
Не меньше внимания требует юридическая и этическая сторона. Отзывы пишут живые люди, у площадок свои правила автоматического доступа, а часть данных они отдают через официальные каналы. Ниже — где хранятся отзывы и как их отдаёт каждый тип площадки, схема данных с минимумом персональной информации, код пагинации, инкрементальное обновление, настройка прокси и первый шаг к анализу тональности.
Резидентные прокси для мониторинга отзывов
Резидентные IP с выбором страны и липкими сессиями для постраничных лент отзывов
Правила до начала сбора
Это часть постановки задачи, а не формальность:
- Только публичные отзывы. Собирайте то, что видит любой посетитель без входа в аккаунт. Не входите в чужие или служебные аккаунты ради скрытых данных и не обходите платный доступ, ограничения доступа и капчи.
- Читайте правила сервиса и robots.txt. Многие площадки ограничивают автоматический сбор в пользовательском соглашении. Если есть официальный API или лицензия на данные, это обычно надёжнее. В спорных случаях консультируйтесь с юристом с учётом вашей страны и задачи.
- Осторожно с персональными данными. Имя автора, ссылка на профиль и фото могут считаться персональными данными по 152-ФЗ, GDPR и похожим законам. Храните только нужные поля, заменяйте идентификаторы авторов псевдонимами и задайте срок хранения.
- Только чтение. Парсер отзывов ничего не публикует. Написание, редактирование, накрутка голосов и генерация отзывов не относятся к этой статье, а фальшивые отзывы во многих странах запрещены законом.
- Бережная нагрузка. Держите частоту запросов низкой и останавливайтесь, если сайт сообщает, что вы слишком быстры.
Где лежат отзывы и как они загружаются
| Тип площадки | Примеры | Как обычно приходят отзывы | Официальная альтернатива |
|---|---|---|---|
| Маркетплейсы | Ozon, Wildberries, Amazon, eBay | Отдельные страницы отзывов или JSON-запросы с номером страницы | Кабинеты продавцов отдают отзывы на собственные товары |
| Карты | Яндекс Карты, 2ГИС, Google Maps | Подгрузка при прокрутке, курсор в ответах XHR | Places API от Google отдаёт лишь несколько отзывов на место, Business Profile API — только по своим точкам |
| Отзовики | Отзовик, IRecommend, Trustpilot, Tripadvisor | HTML с параметром страницы, иногда встроенный JSON | Бизнес-API, в основном для отзывов о своей компании |
| Магазины приложений | Google Play, App Store | Постраничные ленты или JSON-запросы | Консоли разработчика показывают отзывы на свои приложения |
Лимиты официальных API меняются, поэтому перед планированием сверяйтесь с актуальной документацией площадки. Если API отдаёт всё, что нужно по вашим товарам, берите его и обходитесь без парсинга.
Что хранить: компактная запись отзыва
Схему данных продумайте до кода. Короткая запись сохраняет пользу набора и ограничивает объём персональных данных у вас:
| Поле | Пример | Комментарий |
|---|---|---|
source | otzovik-x | Метка площадки |
item_ref | ID товара или места | Связь отзыва с объектом оценки |
review_ref | ID отзыва на площадке или хеш | Для удаления дублей |
rating | 4 | Приводим к шкале 1–5 |
posted_at | 2026-09-14 | Дата в формате ISO |
body | текст отзыва | Без HTML, с переносами строк |
lang | ru | Определённый язык |
author_key | хеш с солью | Никогда не исходное имя или ссылка на профиль |
verified | true | Только если площадка это показывает |
Аватары, ссылки на профили и контакты не сохраняем. Если в самом тексте встречаются телефоны или почта, маскируем их на этапе очистки.
Шаг 1. Находим настоящий источник отзывов
Откройте карточку товара или места, нажмите F12, перейдите на вкладку Network и включите фильтр Fetch/XHR. Затем переключите страницу отзывов или прокрутите блок с ними. Обычно появляется новый запрос, который возвращает JSON с оценками и текстами. Запишите три вещи:
- адрес и параметр, который меняется между страницами (
page,offset,cursor,pageToken); - заголовки, без которых запрос не работает, например язык или referer;
- признак конца ленты: пустой список, отсутствие курсора, флаг
hasMore.
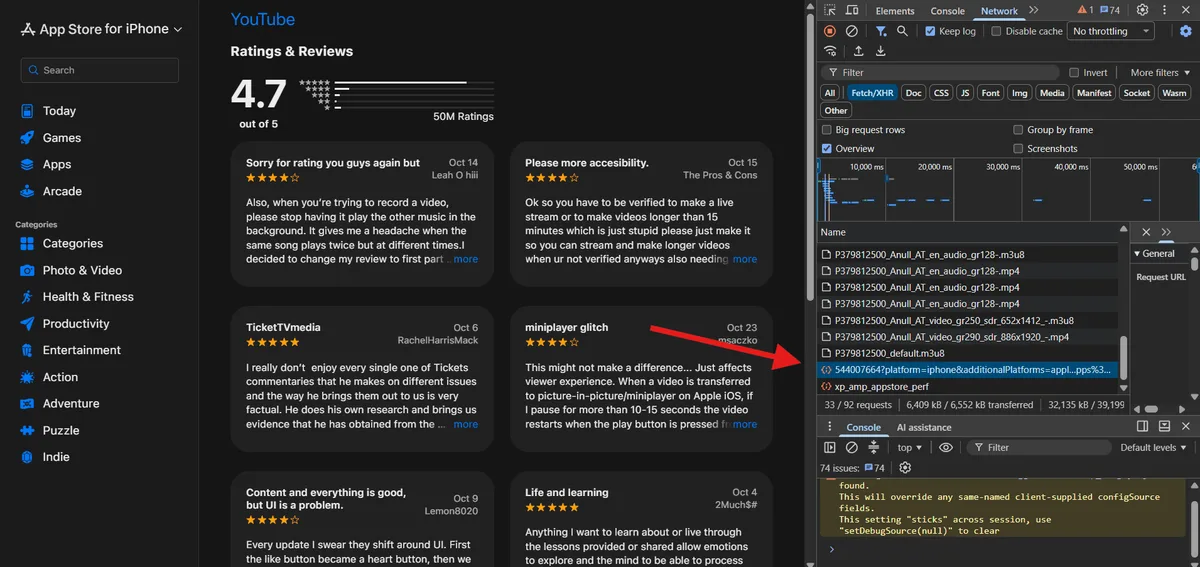
Если такого запроса нет, отзывы лежат прямо в HTML, иногда в виде JSON внутри тега script. Разбирать этот JSON надёжнее, чем привязываться к CSS-классам, которые меняются при каждом редизайне.
Шаг 2. Проходим страницы или курсоры
Ленты отзывов обычно листаются одним из двух способов. С номерами страниц всё просто: увеличиваем счётчик, пока список не придёт пустым. При курсорной пагинации сервер возвращает токен следующей порции, и его отправляют обратно, пока токен не перестанет приходить. Набросок ниже работает с курсором на условном адресе — подставьте имена полей, которые увидели в DevTools.
import os, time, random, hashlib
import requests

GATEWAY = os.environ["GATEWAY_URL"]          # http://user:pass@host:port
SALT = os.environ["AUTHOR_SALT"]
FEED = "https://reviews.example.com/v1/items/{item}/reviews"

session = requests.Session()
session.proxies = {"http": GATEWAY, "https": GATEWAY}
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64)",
    "Accept": "application/json",
    "Accept-Language": "ru-RU,ru;q=0.9",
})

def mask_author(raw_name: str) -> str:
    return hashlib.sha256((SALT + raw_name).encode()).hexdigest()[:16]

def pull_reviews(item_id: str, newest_known: str | None = None):
    token, batch_no = None, 0
    while True:
        params = {"sort": "newest", "limit": 20}
        if token:
            params["cursor"] = token
        reply = session.get(FEED.format(item=item_id), params=params, timeout=30)
        if reply.status_code == 429:
            time.sleep(int(reply.headers.get("Retry-After", 60)))
            continue
        reply.raise_for_status()
        payload = reply.json()
        for entry in payload.get("reviews", []):
            if entry["id"] == newest_known:
                return
            yield {
                "review_ref": entry["id"],
                "rating": entry.get("stars"),
                "posted_at": entry.get("date"),
                "body": entry.get("text", "").strip(),
                "author_key": mask_author(entry.get("author", "")),
            }
        token = payload.get("nextCursor")
        batch_no += 1
        if not token:
            return
        time.sleep(random.uniform(1.5, 4.0))
Здесь важны две детали. Сортировка по новизне вместе с проверкой newest_known превращает каждый следующий запуск в дешёвое дообновление: цикл останавливается, как только встречает уже сохранённый отзыв. А ветка для кода 429 ждёт столько, сколько просит сервер, вместо мгновенных повторов.
Шаг 3. Сохраняем, убираем дубли, обновляем
Записывайте отзывы в таблицу с уникальным ключом из source и review_ref. Если площадка не показывает ID отзывов, сделайте ключом хеш от оценки, даты и первых 200 символов текста. Отзывы редактируют и удаляют, поэтому при долгом мониторинге храните дату last_seen и время от времени перечитывайте свежие страницы, а не всю историю. Для выгрузки JSON Lines сохраняет вложенные данные, а CSV сразу открывается в таблицах.
Шаг 4. Прокси: когда нужны и какие выбрать
Несколько сотен отзывов на один товар обычно собираются без прокси, достаточно аккуратных пауз. Прокси становятся нужны в трёх случаях:
- Объём. Мониторинг тысяч товаров или точек — это много запросов в день, и срабатывают лимиты на один IP.
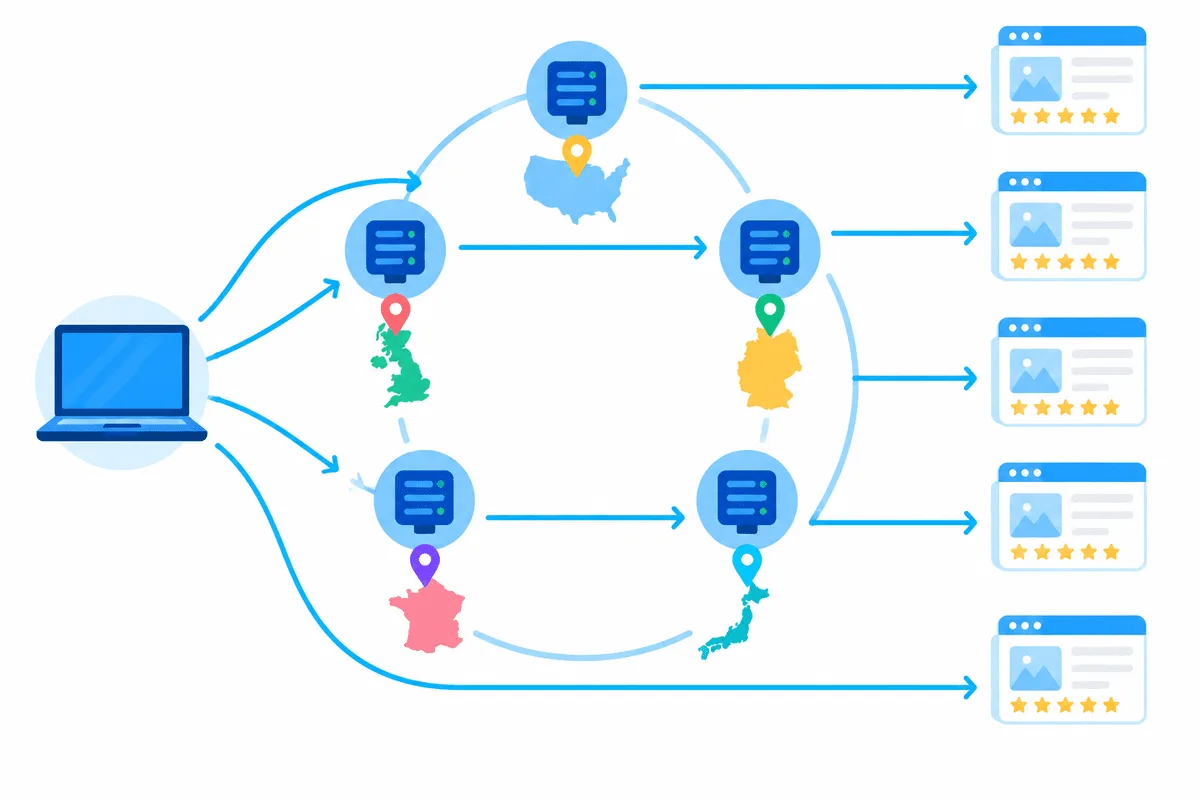
- География. Карты и маркетплейсы часто показывают разные отзывы, языки и порядок сортировки в зависимости от страны или города посетителя. IP в нужном регионе показывает картину глазами местных покупателей.
- Стабильность. Диапазоны дата-центров крупные площадки распознают быстро, и запросы с них чаще получают отказ.
Для лент отзывов обычно берут резидентные прокси с выбором страны. Держите одну липкую сессию на всю цепочку курсоров одного товара — некоторые ленты привязывают курсор к сессии — и меняйте IP между товарами. Разница режимов разобрана в статье о липких и ротируемых прокси, а паузы и заголовки — в материале о прокси для парсинга. Особенности сбора с маркетплейсов на примерах — в статьях о парсинге Wildberries и Ozon.
Шаг 5. От текста к выводам: тональность и темы
Средняя оценка скрывает большую часть информации. Три шага превращают сырые отзывы в материал для продуктовой или маркетинговой команды:
- Определение языка и очистка. Разделите отзывы по языкам, уберите разметку, замаскируйте персональные данные.
- Оценка тональности. Для английского быстрый результат даёт словарь VADER из пакета
vaderSentiment— итоговая оценка от −1 до 1. Для русского лучше подходят многоязычные или русскоязычные модели-трансформеры: они точнее, но требуют больше ресурсов. - Группировка по аспектам. Посчитайте, как часто фразы о доставке, размере, батарее, персонале или цене встречаются в негативных и позитивных отзывах. Так видно, что именно снижает оценки.
from vaderSentiment.vaderSentiment import SentimentIntensityAnalyzer

scorer = SentimentIntensityAnalyzer()

def tone(text: str) -> str:
    value = scorer.polarity_scores(text)["compound"]
    if value >= 0.05:
        return "positive"
    if value <= -0.05:
        return "negative"
    return "neutral"
Вместе с ценами и наличием динамика отзывов — стандартная часть анализа конкурентов; как настраивают такой мониторинг, рассказано в статье о прокси в маркетинговой аналитике.
Частые проблемы
| Что видим | Вероятная причина | Что сделать |
|---|---|---|
| На странице отзывы есть, в HTML — нет | Отзывы подгружаются через XHR после отрисовки | Использовать JSON-запрос из DevTools |
| Курсор перестаёт работать через несколько страниц | Курсор привязан к сессии или IP | Одна липкая сессия на товар |
| Один отзыв попадает дважды | Страницы сдвигаются, пока приходят новые отзывы | Уникальный ключ по ID отзыва или хешу содержимого |
| 403 или страница проверки | IP под подозрением, нет заголовков, слишком быстро | Замедлиться, заголовки как у браузера, резидентные IP; проверки автоматически не проходить |
| 429 Too Many Requests | Лимит частоты | Учитывать Retry-After, снизить параллельность |
| Отзывы отличаются от того, что видит коллега | Другие страна, язык или сортировка | Зафиксировать страну выхода и явно передавать язык |
Частые вопросы о парсинге отзывов
Законно ли парсить отзывы покупателей?
Это зависит от страны, правил площадки и того, как вы используете данные. Сбор публичных отзывов для анализа распространён, но его могут ограничивать пользовательское соглашение, права на базы данных и законы о персональных данных, поэтому проверяйте правила каждого сайта и для коммерческих проектов советуйтесь с юристом.
Можно ли сохранять имена авторов отзывов?
Лучше не сохранять без ясного правового основания. Имя и ссылка на профиль обычно считаются персональными данными, поэтому храните хеш с солью: он позволяет группировать отзывы по автору, не раскрывая его личность.
Почему через API Google приходит только пять отзывов?
Places API от Google отдаёт лишь небольшую выборку отзывов на место, и точное число может меняться, поэтому сверяйтесь с актуальной документацией. Полный список через Business Profile API доступен только по точкам, которыми вы владеете или управляете.
Нужны ли прокси для парсинга отзывов?
Для небольших и медленных задач — нет. Они полезны, когда вы отслеживаете много товаров или точек, хотите видеть отзывы глазами покупателей конкретной страны или постоянно упираетесь в лимиты на IP; для большинства лент подходят резидентные прокси с липкими сессиями.
Как поддерживать базу отзывов в актуальном состоянии?
Сортируйте ленту по новизне, запоминайте ID последнего сохранённого отзыва по каждому товару и останавливайте обход, когда до него дойдёте. Время от времени перечитывайте свежие страницы, чтобы заметить правки и удаления.