Парсинг Telegram-каналов и чатов: Telethon, веб-превью и прокси

Собрать данные из Telegram-канала можно двумя способами: подключиться к официальному API по протоколу MTProto через библиотеку вроде Telethon и выгрузить историю сообщений или открыть публичное веб-превью t.me/s/<канал> и разобрать его HTML. Первый путь даёт полные структурированные данные обо всём, что видит ваш аккаунт. Второй работает вообще без аккаунта, но только для публичных каналов и с более скромным набором полей.
Типичная статья на эту тему — готовый скрипт на сорок строк и больше ничего. Здесь мы сравним оба пути, разберём сборщик на Telethon с настройкой прокси и обработкой FloodWait, напишем парсер веб-превью, расскажем, что случилось с Pyrogram, какие ограничения ставит Telegram и какой тип прокси подходит для каждого случая. Речь только о публичных каналах и группах, в которые вы вступили сами, а не о сборе сведений о людях.
SOCKS5-прокси
Стабильные SOCKS5-прокси с логином и паролем, которые Telethon поддерживает без доработок
Два способа получить данные Telegram
| API MTProto (Telethon) | Веб-превью t.me/s/ | |
|---|---|---|
| Нужен аккаунт | Да: номер телефона, api_id и api_hash | Нет |
| Что доступно | Публичные каналы, группы, где вы участник, ваши чаты | Только публичные каналы, если владелец не отключил превью |
| Поля | Полный объект сообщения: id, дата, текст, просмотры, репосты, ответы, реакции, сведения о медиа, дата правки | Текст, дата, счётчик просмотров, ссылка на пост, часть ссылок на медиа |
| Глубина истории | Вся история постранично по id сообщения | Около 20 постов на страницу, более старые через ?before= |
| Главное ограничение | FloodWait на аккаунт | Ограничение частоты запросов на IP |
| Зачем прокси | Доступ из сетей с ограничениями, постоянный адрес выхода | Распределение запросов, выбор региона |
Для аналитики по нескольким каналам API почти всегда удобнее: данные чище, вёрстка не ломает парсер, счётчики точные. Веб-превью пригодится для быстрого мониторинга без номера телефона или чтобы увидеть канал глазами анонимного посетителя.
Правила до начала работы
У Telegram есть условия использования API для сторонних клиентов. Они запрещают спам, флуд и накрутку подписчиков и просмотров, а от разработчиков ждут уважения к приватности пользователей. Держитесь этих условий и законов своей страны:
- собирайте данные из публичных каналов или групп, куда вы вступили под своим аккаунтом; не заводите аккаунты ради доступа;
- списки участников и профили — это персональные данные. По GDPR, 152-ФЗ и похожим законам для их хранения нужно основание, поэтому в большинстве исследований их лучше агрегировать или не собирать вовсе;
- храните id сообщений и названия каналов, а не копии всех картинок и видео, если у вас нет прав на медиа;
- остановитесь, когда Telegram просит снизить темп. FloodWait — это просьба, а не препятствие, которое нужно обойти.
Общий взгляд на сбор публичных постов есть в нашем обзоре про сбор данных из социальных сетей.
Путь 1: Telethon и официальный API
Telethon — асинхронная библиотека для Python, которая работает по MTProto, тому же протоколу, что и официальные приложения. Скрипт входит как обычный пользовательский аккаунт и видит ровно то, что видит этот аккаунт.
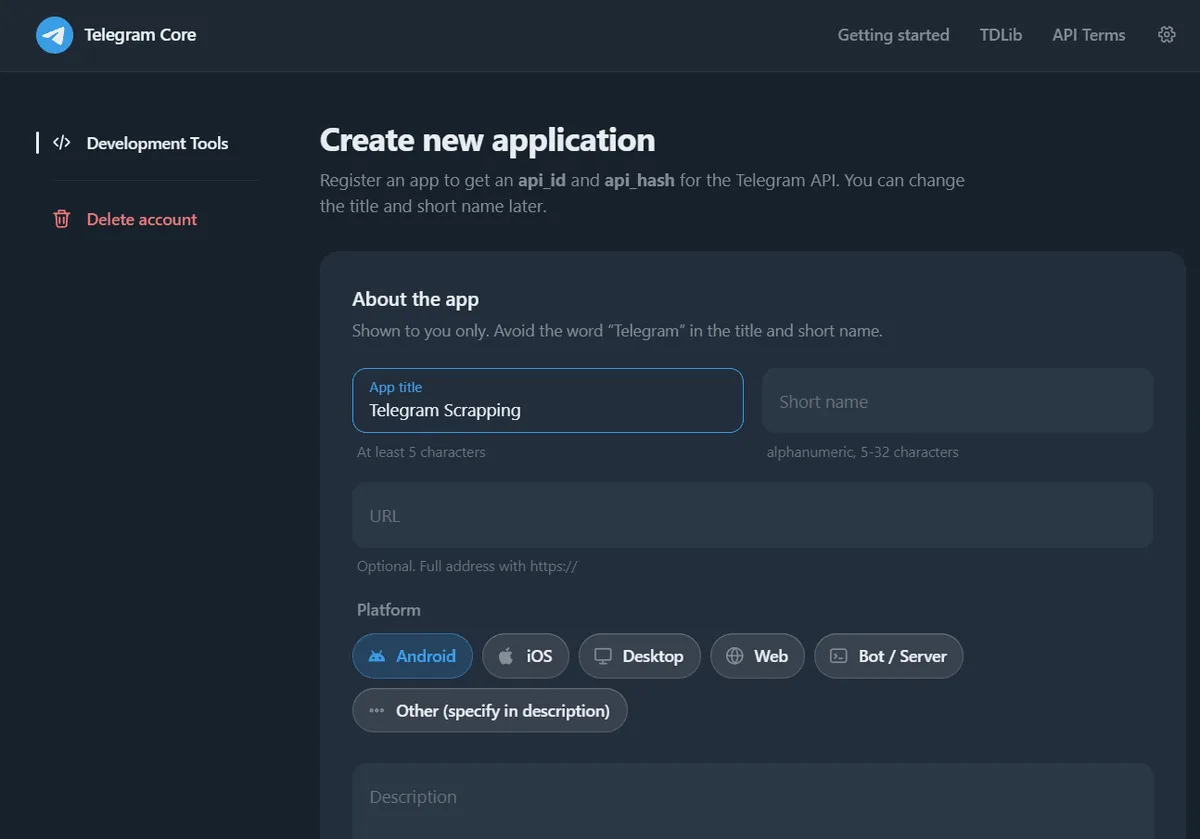
Шаг 1. Зарегистрируйте приложение
Откройте my.telegram.org, войдите по номеру телефона, перейдите в раздел API development tools и создайте приложение. Вы получите два значения: api_id и api_hash. Не храните их в репозитории — читайте из переменных окружения.
Шаг 2. Установите библиотеки
pip install telethon "python-socks[asyncio]"Второй пакет Telethon использует для SOCKS- и HTTP-прокси. Без него параметр прокси пропускается, а в консоли появляется предупреждение.
Шаг 3. Подключитесь через прокси
Прокси в Telethon передаётся словарём. Ключи взяты из документации библиотеки, адрес и логин — условные.
import os
from telethon import TelegramClient

shlyuz = {
    "proxy_type": "socks5",
    "addr": "203.0.113.40",
    "port": 1080,
    "username": "tg-reader-01",
    "password": "zamenite-menya",
    "rdns": True,
}

client = TelegramClient(
    "chitatel_kanalov",               # имя локального файла сессии
    int(os.environ["TG_API_ID"]),
    os.environ["TG_API_HASH"],
    proxy=shlyuz,
)
При первом запуске Telethon спросит в консоли номер телефона и код входа, а затем сохранит файл .session. Берегите его как пароль: у того, кто им владеет, есть доступ к вашему аккаунту.
Если у вас только MTProto-прокси (хост, порт и секрет), Telethon подключается к нему через отдельный класс соединения connection.ConnectionTcpMTProxyRandomizedIntermediate с параметром proxy=(host, port, secret). Чем отличаются эти два вида прокси, мы разбирали в материале про MTProto-прокси.
Шаг 4. Выгрузите историю канала
import asyncio, csv
from telethon import errors

KANALY = ["example_news", "example_tech"]

async def sobrat():
    await client.start()
    with open("posty.csv", "w", newline="", encoding="utf-8") as fail:
        tablica = csv.writer(fail)
        tablica.writerow(["kanal", "msg_id", "data", "prosmotry", "reposty", "tekst"])
        for imya in KANALY:
            try:
                async for post in client.iter_messages(imya, limit=500):
                    tablica.writerow([imya, post.id, post.date.isoformat(),
                                      post.views, post.forwards,
                                      (post.message or "").replace("\n", " ")])
            except errors.FloodWaitError as pauza:
                print(f"{imya}: Telegram просит подождать {pauza.seconds} с, останавливаемся")
                break
            await asyncio.sleep(5)       # передышка между каналами

with client:
    client.loop.run_until_complete(sobrat())
Несколько полезных деталей. iter_messages сам листает историю пачками, от новых сообщений к старым; чтобы идти вперёд от нужной даты, передайте reverse=True вместе с offset_date. Поле post.views заполняется только у постов каналов. Для дозагрузки сохраняйте максимальный msg_id по каждому каналу и в следующий раз передавайте его как min_id — придут только новые посты.
Лимиты и FloodWait
Точных квот Telegram не публикует. Когда аккаунт слишком часто вызывает какой-то метод, сервер отвечает ошибкой FLOOD_WAIT_X, где X — сколько секунд нужно ждать. Telethon превращает её в исключение FloodWaitError и по умолчанию сам выжидает короткие паузы (настройка flood_sleep_threshold, из коробки 60 секунд). Более длинные паузы передаются в ваш код.
Привычки, которые берегут аккаунт:
- определяйте канал по имени один раз и кэшируйте результат, а не запрашивайте его при каждом запуске;
- читайте историю несколькими крупными пачками вместо тысяч мелких вызовов;
- запускайте сбор по расписанию (раз в час или в день), а не в бесконечном цикле;
- держите один аккаунт на проект и не меняйте IP посреди сессии.
Последний пункт — про стабильность, а не про анонимность. Сессия, которая прыгает между странами, похожа на украденный вход, и Telegram может её завершить и попросить авторизоваться заново.
А что с Pyrogram?
Pyrogram была второй популярной библиотекой для MTProto, но в декабре 2024 года её репозиторий на GitHub перевели в архив, а в README указано, что проект больше не поддерживается. Старые скрипты работают, пока Telegram не изменит то, на что они опираются. Сообщество продолжает код в форках под новыми именами; если выбираете форк, сначала посмотрите историю релизов и трекер задач. Для нового проекта в 2026 году надёжнее взять Telethon. В Pyrogram прокси задавался словарём с ключами scheme, hostname, port, username и password, и большинство форков этот формат сохранили.
Путь 2: парсинг публичного веб-превью
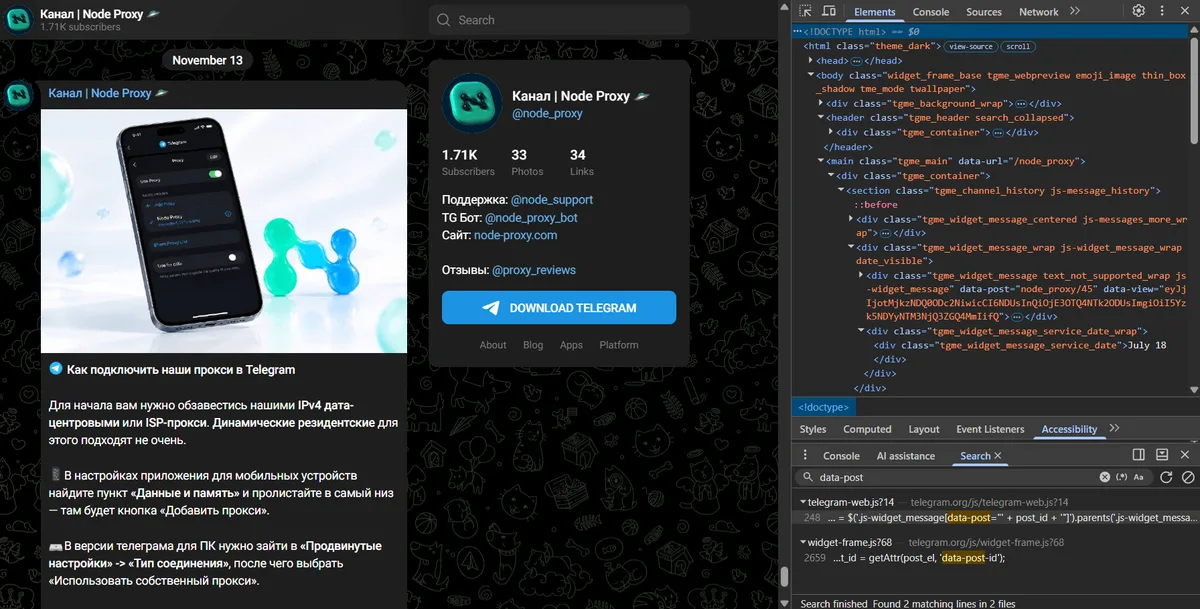
У каждого публичного канала с включённым превью есть страница https://t.me/s/<имя>, где последние посты отданы обычным HTML. Её можно прочитать любым HTTP-клиентом и разобрать парсером вроде BeautifulSoup. Названия классов ниже соответствуют странице на момент написания статьи — сверьте их в DevTools.
import time, requests
from bs4 import BeautifulSoup

vyhod = "http://tg-reader-01:zamenite-menya@203.0.113.40:8000"
seans = requests.Session()
seans.proxies = {"http": vyhod, "https": vyhod}
seans.headers["User-Agent"] = "Mozilla/5.0 (Windows NT 10.0; Win64; x64)"

def stranica_prevyu(imya, before=None):
    url = f"https://t.me/s/{imya}" + (f"?before={before}" if before else "")
    soup = BeautifulSoup(seans.get(url, timeout=20).text, "html.parser")
    posty = []
    for kartochka in soup.select("div.tgme_widget_message[data-post]"):
        tekst = kartochka.select_one(".tgme_widget_message_text")
        schetchik = kartochka.select_one(".tgme_widget_message_views")
        vremya = kartochka.select_one("time[datetime]")
        posty.append({
            "post": kartochka["data-post"],
            "tekst": tekst.get_text(" ", strip=True) if tekst else "",
            "prosmotry": schetchik.get_text(strip=True) if schetchik else None,
            "data": vremya["datetime"] if vremya else None,
        })
    return posty

pachka = stranica_prevyu("example_news")
time.sleep(3)
Атрибут data-post выглядит как channel/1234: возьмите число после косой черты и запросите ?before=1234, чтобы получить предыдущую страницу. Просмотры приходят в сокращённом виде (например, 12.4K), их нужно перевести в числа самостоятельно. Если страница канала пустая, скорее всего, владелец отключил превью, и законный путь остаётся только через API.
Какие прокси нужны для парсинга Telegram
На двух путях прокси решают разные задачи.
Для API. Соединений мало, поэтому нужен один надёжный выход, а не пул. Основные причины — сетевые ограничения (офис, страны, где Telegram фильтруется) и постоянный чистый адрес для долгоживущей сессии. Лучше всего подходят SOCKS5-прокси: Telethon поддерживает их без надстроек, а статический адрес сохраняет сессию стабильной. Используйте один и тот же выход при каждом запуске сессии.
Для веб-превью. Здесь идут обычные HTTP-запросы, и Telegram ограничивает частоту, когда один адрес выкачивает сотни страниц. Распределите нагрузку на несколько выходов и делайте паузу в несколько секунд между страницами. Нужны ли постоянные или ротируемые прокси, зависит от объёма: для десятка каналов хватит одного постоянного IP.
Если нужно просто открыть сам Telegram через прокси, а не собирать данные, пригодится инструкция по настройке прокси в Telegram на компьютере и телефоне. Общие принципы работы с пулами прокси при сборе данных описаны в статье про прокси в веб-скрейпинге.
Частые ошибки
| Сообщение | Что значит | Что делать |
|---|---|---|
FloodWaitError | Слишком много вызовов одного метода | Подождать указанные секунды и снизить частоту |
UsernameInvalidError / UsernameNotOccupiedError | Неверное или удалённое имя канала | Проверить имя, использовать числовой id, если он известен |
ChannelPrivateError | Канал закрытый или вас удалили | Нужно законное приглашение; иначе пропустить канал |
AuthKeyDuplicatedError | Один файл сессии используется в двух местах одновременно | Запускать один процесс на файл сессии |
| Тайм-ауты соединения | Прокси недоступен или не установлен python-socks | Проверить прокси отдельно, установить пакет |
Пустая страница t.me/s/ | Владелец отключил превью | Использовать API с аккаунтом, которому виден канал |
Частые вопросы о парсинге Telegram
Законно ли парсить Telegram-каналы?
Чтение публичных каналов для анализа обычно допустимо, но условия API Telegram запрещают спам и накрутки, а к любым персональным данным, которые вы храните, применяются законы о защите данных. Собирайте публичные посты, по возможности агрегируйте их и не составляйте профили отдельных пользователей.
Можно ли парсить Telegram без аккаунта?
Да, если канал публичный и у него включено веб-превью: на странице t.me/s/ последние посты отдаются обычным HTML. Закрытые каналы, группы и полные метаданные сообщений доступны только через API с авторизацией.
Поддерживается ли ещё Pyrogram?
Нет. Исходный репозиторий в декабре 2024 года перевели в архив и пометили как неподдерживаемый. Форки сообщества существуют, но для нового кода Telethon — более консервативный выбор.
Сколько запросов можно отправить, пока Telegram не ограничит доступ?
Фиксированных лимитов Telegram не публикует. Он отвечает ошибкой FloodWait с числом секунд паузы, а порог зависит от метода и истории аккаунта. Объединяйте запросы в пачки, кэшируйте поиск каналов и запускайте сбор по расписанию.
Нужен ли прокси для парсинга Telegram?
Не всегда. При работе через API прокси нужен в основном там, где Telegram ограничен в сети, или для постоянного выделенного адреса сессии. Для веб-превью прокси помогают, когда вы загружаете много страниц и не хотите упираться в ограничения на один IP.